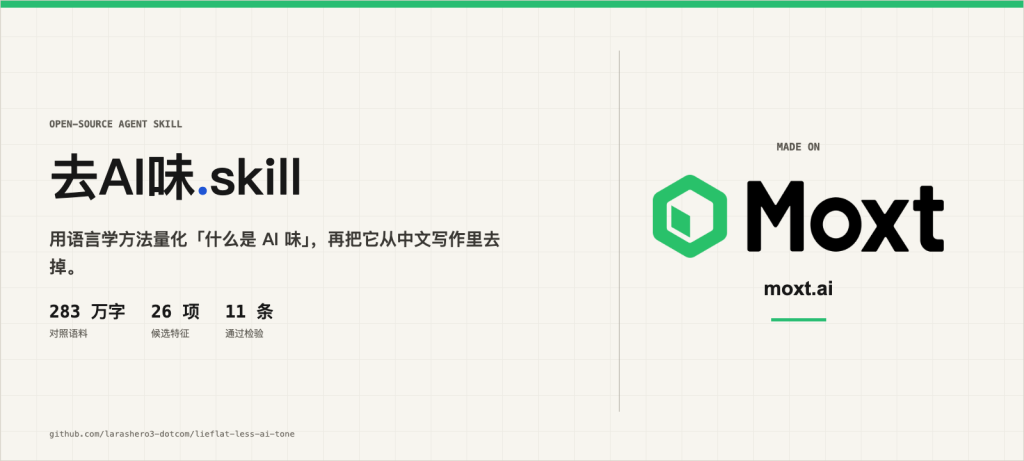
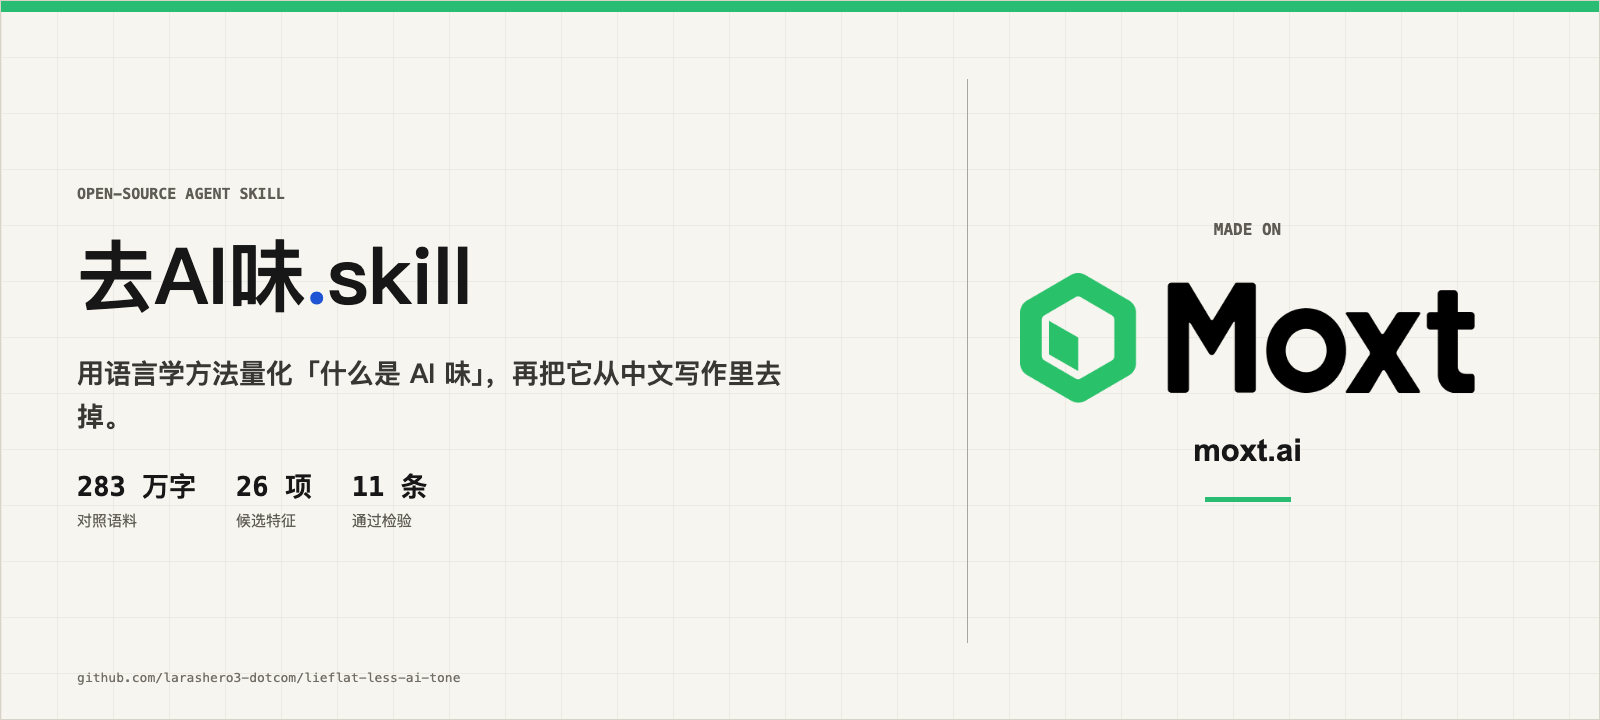
机器写的文字有股味,很多人能凭感觉挑出几条:破折号太多、爱说「不是 A 而是 B」。真拿 629 篇文章数过一遍,一半多的说法站不住:人类用比喻的频率是生成文本的 2.4 倍,正文设问句是 17 倍。Lieflat Less AI Tone 就是这次点数变成的改写规则,装上就能交给 AI 执行。
它是什么
Lieflat Less AI Tone 是一个去 AI 味的 Skill工具,做的是两件事:先把「什么是 AI 味」量化出来,再把量出来的结果变成能交给 AI 执行的改写规则。它属于 写作 工具里少见的做法——不靠语感,靠统计。作者用 629 篇文章建成对照语料,共 2,826,972 汉字、95,551 句、45,721 段;其中 300 篇由五个模型在不联网、不加风格指令、只给话题的条件下生成,329 篇来自人类作者的公开文本。代码以 开源 方式放在 GitHub 上,归入 实用软件 一类也说得通。
场景痛点
做内容这行的人,大概都接过这样的稿子:通顺、干净、挑不出错,可一读就知道不是人写的。想说清哪里别扭,多数人只能挑出几个零碎——破折号多了、爱用「不是 A 而是 B」、句子长短差不多。网上流传的判别清单基本都是这么来的,互相转,转到最后就成了常识。AI写作 的麻烦就在这儿:清单里哪些真有区分力、哪些只是印象、哪些方向甚至是反的,从来没人系统地数过。更尴尬的是,照着错的条目去改,改完离人话更远。
功能特点
一、真数了一遍,结论才敢写
研究检验了 26 项候选特征,逐项计算生成侧与人类侧的频率比,记做 R。判定有硬杠:R 大于等于 2 才纳入; 1.25 到 2 之间要求人类各组数值一致、绝对量也够;0.8 到 1.25 视为没有区分力,直接排除; 小于 0.8 说明人类用得更多,同样不能拿来当删改依据。结果是 11 项通过,15 项被排除。 对做 内容创作 的人来说,这份清单比那些转来转去的经验帖可靠得多。
二、通过检验的项目,集中在大结构上
11 项里最值得说的是,它们大多不在用词层面,而在篇章与结构层面。 区分力最强的是段首零回指评论,比值 4.4 倍:新段落一开头就抛出评价,却不说明在评价谁, 读者得回头看上一段才能确定所指。有意思的是,段首衔接词的总体密度两侧几乎一样, 生成侧 14.4%,人类侧 15.1%,差别只在评价句省掉了回指成分——补一个指示代词就能接上。 其余通过的项目包括对举结构、破折号、提示性冒号、序词小标题、拟人化喻体、起首语与五类译文句式。
三、三项结论和流行说法相反
被排除的 15 项里,有三项和大家的印象正好相反。人类使用比喻的频率是生成文本的 2.4 倍, 用比喻独立起段的更是 8 倍:差别不在用不用,而在喻体——模型爱拿理想化的职业人格作比, 人类更常取身边具体的人。正文设问句,人类是模型的 17 倍,照着「删掉设问」的建议改,只会更像机器。 句长均匀度也一样,研究初期曾算出 51 倍的差距,查下来是断句程序的缺陷,修正后是 0.87,等于没差别。
四、不同模型的味并不一样
大语言模型 之间的差别大得出乎意料。同一个特征,模型之间能差到四十倍:破折号这一项, 最高的每千字超过 5 次,最低的只有 0.11 次;提示性冒号最重的是其中两家,问句小标题最重的又是另一家。 研究初期只用两个模型、30 篇样本时,曾得出「破折号是某个模型独有」的结论,扩到五个模型后被推翻。 这也意味着,市面上基于单一模型样本总结出的「AI 文风」,未必站得住。
五、改写规则带着三道约束
统计上成立不等于能拿来改稿,所以规则集另加了三条。只处理清单内的 11 项,没命中的句子逐字保留, 标题层级、段落次序、列表、表格与代码块都不动。不新增姓名、数字、日期、引语、来源或因果关系, 也不删原文的观点、结论与限定成分——把「可能提升」改成「提升」属于篡改判断强度,不属于清理风格。 比喻是否贴切、设问有没有必要、案例算不算堆砌,这三类要靠语义理解,写不成规则,一律排除。
使用教程
第一步,装进 agent。命令行执行仓库里给的安装命令,装好之后提交文本,就按规则集处理。
第二步,不想装也能用。把仓库里那份规则文件当作系统提示词,任何支持自定义指令的工具都能接, 这一步不需要 GitHub 账号,也不挑平台。想省事的话,作者也提供了在线入口,直接在 MoxtHub 打开即可, 那边上下文空间更大,处理长文更从容。
第三步,配合风格蒸馏。如果已经装了同作者的写作风格蒸馏工具,不必再单独装这套规则,那边已内置一份。 两套同时用时,同目录下有蒸馏产物就优先读它;两者冲突以蒸馏产物为准, 因为它记录的是目标作者的实际写法,不属于生成痕迹。在 AI教程 这条线上,两者是前后两道工序。
第四步,想自己核一遍,仓库给了三个脚本,句层、段落层、译文句式各一个, 按目录读入 md 文件即可复算全部指标,脚本本身不含语料。
使用感受
第一点,最值钱的是那段测量失误记录。六次失误一条条列出来,全是算子覆盖范围宽于规则定义造成的, 其中两次方向还是反的——照着错的结论去改,会把稿子推得更远。把翻车过程摊开讲,比直接给一堆结论有说服力。
第二点,判据定得清楚,不是拍脑袋。什么算通过、什么算条件通过、什么直接排除,都给了阈值和理由; 还额外要求人类各组之间不能差太多、特征要能定位到具体哪一句哪个词、改起来要可操作。 最后一条附加约束最实在:材料密度确实是人类更高,但为了凑密度去「补数据」会破坏信息守恒, 所以整条只保留能执行的部分。
第三点,边界写得老实,这点难得。语料因为版权和隐私没公开,数字第三方核不了; 人类侧分组之间差异本来就大,扩样本可能改结论;话题没有严格配对;模型还在迭代, 破折号频率不到一年就从近乎每句一次降到 0.11,所以所有数值都只是某个时点的观测。 它归到 工具推荐 里偏研究的那一类,放在 AI相关 下面也合适,愿意较真的人会喜欢。
官方网站
https://github.com/larashero3-dotcom/lieflat-less-ai-tone
下载地址
https://pan.quark.cn/s/4fd6469cc4bd
https://www.guangyapan.com/s/1947499842434752542_aeWhI5wocgzRgCO6
相关推荐

No AI Slop – 清理 20 多种 AI 写作套路,降低文章 AI 味,识别并清理常见 AI 冗余表达
 2026-08-13

Chinese Tech Doc Style – AI中文技术文档写作Skill规范工具与README优化指南
2026-08-09

oil-tone AI文风优化工具:减少AI味提升文章自然度的开源Skill|解决AI文章空泛和模板化问题
2026-07-30