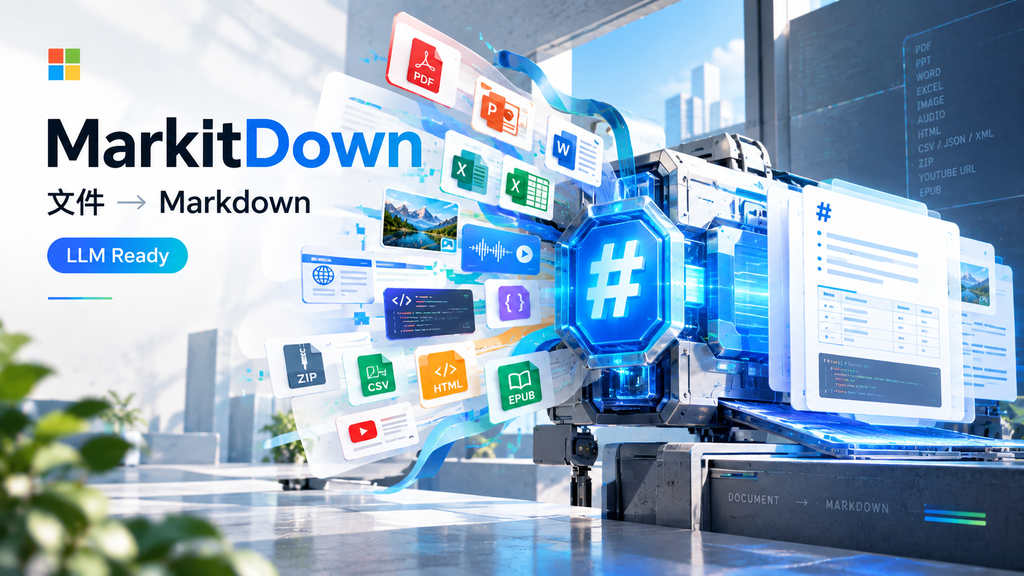
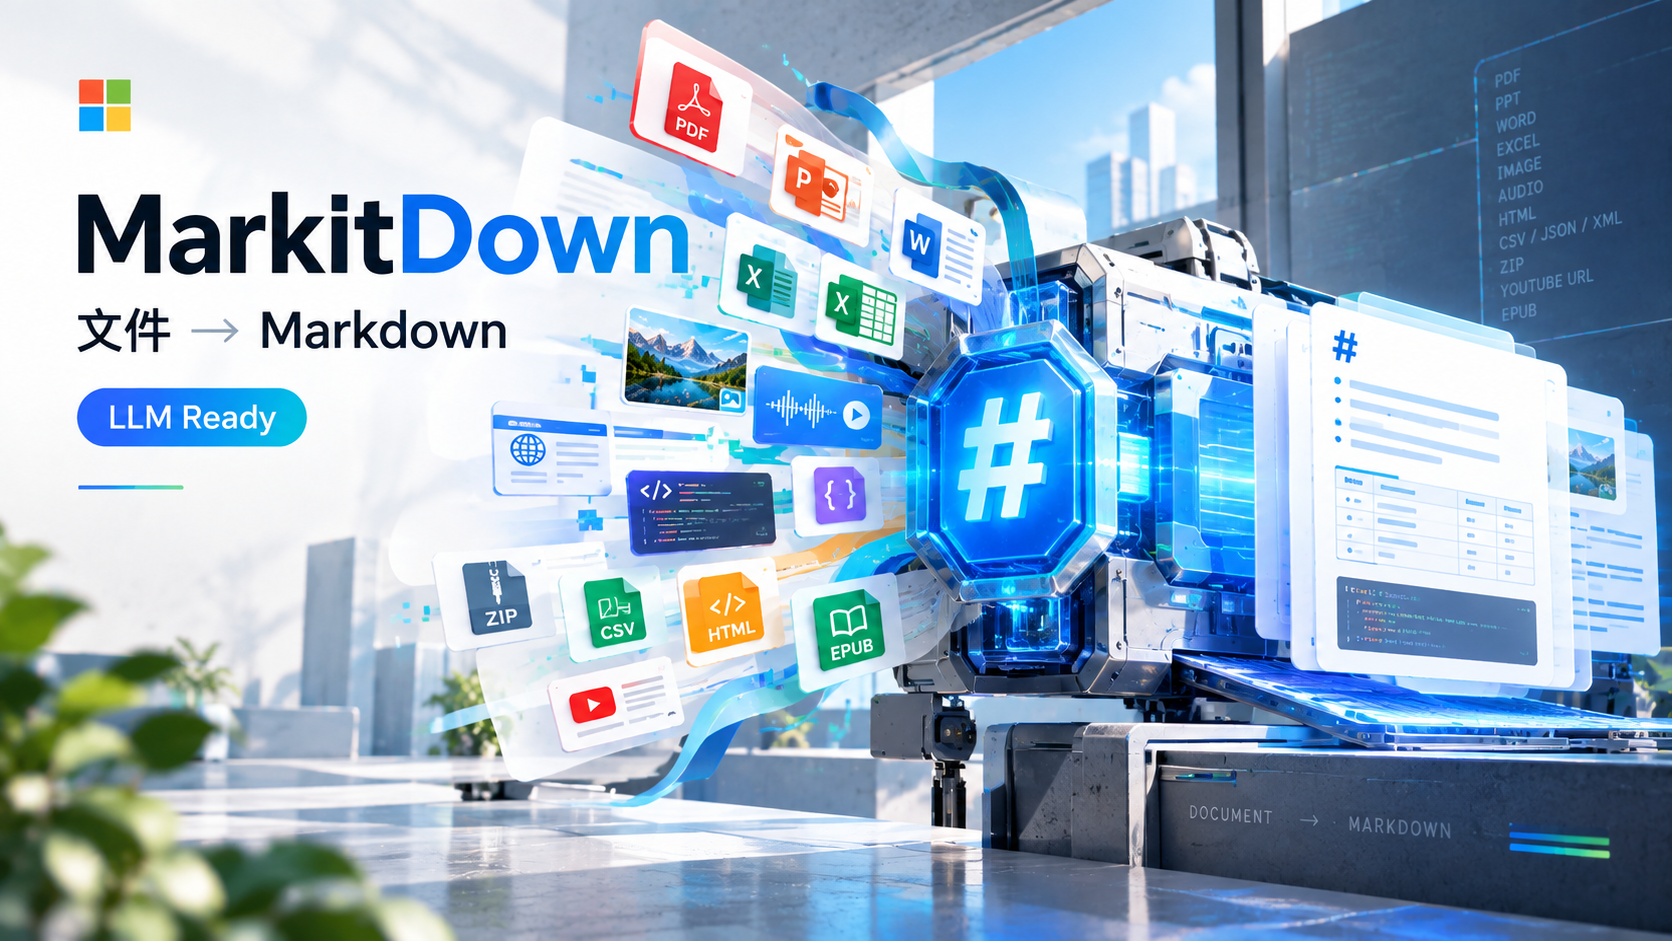
今天看到一个挺有意思的转档工具,叫 MarkItDown 是微软推出的开源项目,简单来说,它想做的事情就一件:把手头那些格式五花八门的文件——文档、表格、幻灯片、网页、图片、录音——统统变成一份干干净净的文字稿,归在实用软件这一类。做内容这行的人最怕材料乱,它这一步替你收拾得挺利索,也难怪会被当成AI工具来看。
功能特点
一口气认下几十种格式
能认下的格式很多,作为一枚软件工具,常见的大致有这些:
- PDF 文档
- Word 文稿
- Excel 表格
- 幻灯片
- 网页与电子书
- 邮件与压缩包
- 图片(读拍摄信息并做文字识别)
- 音频(转成文字稿)
压缩包不用先解压,它会逐个读里面的文件。CSV、JSON、XML 这类数据文件,读出来是整齐的表格。图片会顺带读出拍摄信息,音频能转成文字,输出时保留标题、列表、表格和链接这些骨架。
一行命令转成文字
最常用的用法就一行命令,把文件转成 Markdown 存盘:
想写进自己的脚本里也行,几行代码就能把一份表格读成有层次的文字。针对 PDF工具这类重点格式,官方还准备了对应的处理模块,转换更稳。
接上模型,读懂图片
除了转文字,它还能调用大模型来识别图片内容,比如说出一张截图里有什么,目前支持幻灯片和图片这两类。官方还有个markitdown-ocr插件,专门给扫描版文档补上文字识别。要注意的是,不接模型的话识别会静默跳过,只走内置的转换流程。
它也有边界
不追求把版面还原得一模一样,抓的是标题、列表、表格、链接这些骨架。官方也明说,输出是给文本分析工具用的,不适合当高保真排版工具。复杂排版的文档仍可能读走眼,关键数据建议人工复核一遍。它更像个文字编辑式的整理工,把材料理顺,而不是精排版。
场景痛点
做内容、做编辑这行的人,应该都有过这种感受:手上一堆材料,文档、表格、幻灯片混在一起,想喂给模型,或者建个能检索的资料库,得一份份另存为。折腾半天,还可能把结构弄丢。MarkItDown想解决的,就是这个「先归一」的麻烦——文件丢给它,出来就是一份干净文字稿。对天天和材料打交道的人来说,它算个效率工具,也是知识管理里最省体力的那一环。
使用教程
想用上它,其实就三步。
第一步,准备好运行环境。需要本机装 Python 3.10 或更高版本,官方建议先建一个虚拟环境,免得和别的依赖打架。
第二步,装它。在终端敲一行就行:
如果只想转某几种格式,也可以只装对应的模块,比如只挑文档和表格那几项,体积小不少。
第三步,转文件。最简单的转换就一行:
要批量处理一个文件夹,写个简短的循环脚本逐一调用即可。它也支持在代码里当零件用,对会写脚本的人来说是个顺手的开发者工具。项目就托管在 GitHub 上,装好随时能查用法。
使用感受
第一点,它够省事。原来要一份份另存为的活儿,现在一行命令就解决了,批量跑也不心疼——不联网、不耗对话额度,纯本地跑完就行。
第二点,它够清醒。它明说自己是给模型喂料的,不是给人做精排版的,定位摆得很正。复杂排版会看走眼这点也不藏着,关键数据人工复核一遍就稳了。
第三点,它够大方。微软出品,宽松的开源协议,能改能分发,用在自己的项目里也放心。值得放进工具推荐清单,作为一枚开源软件,日常整理材料时随手就能用。
官方网站
下载地址
https://pan.quark.cn/s/8b1ad224d7c1
相关推荐
YI TUO HUB STUDIO 公众号排版工坊:Markdown 一键排成公众号样式|18 基础主题 + 15 高级排版 + 74 动效组件
 2026-09-14

GenOffice – Genspark 出品的开源 AI 办公套件|能够对让ai对office系列文件做精确修改
2026-09-11

Easel – 浙大 REAL 实验室开源的社媒内容工作台:接入小红书、抖音、快手、知乎、B 站、视频号
2026-09-11