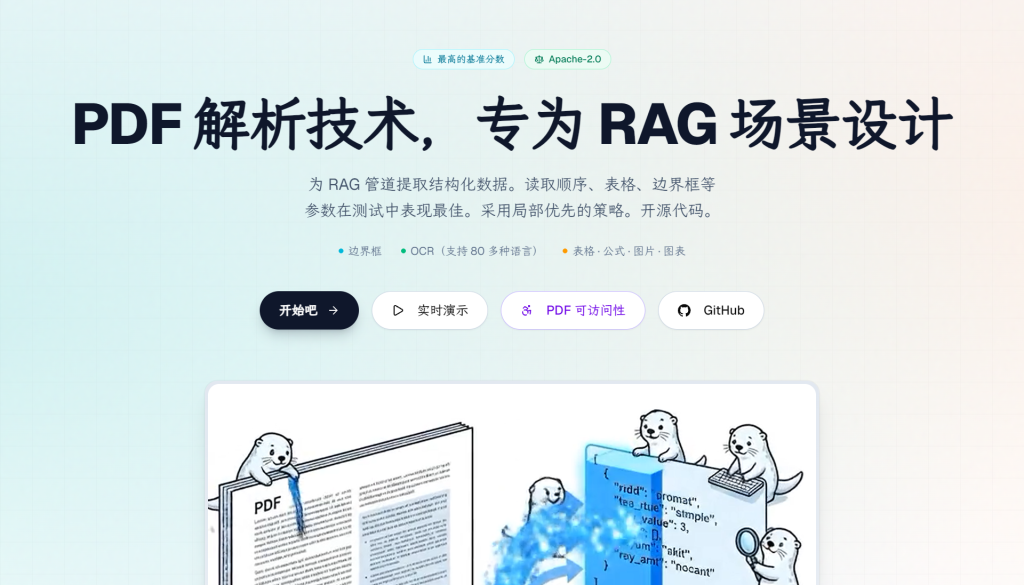
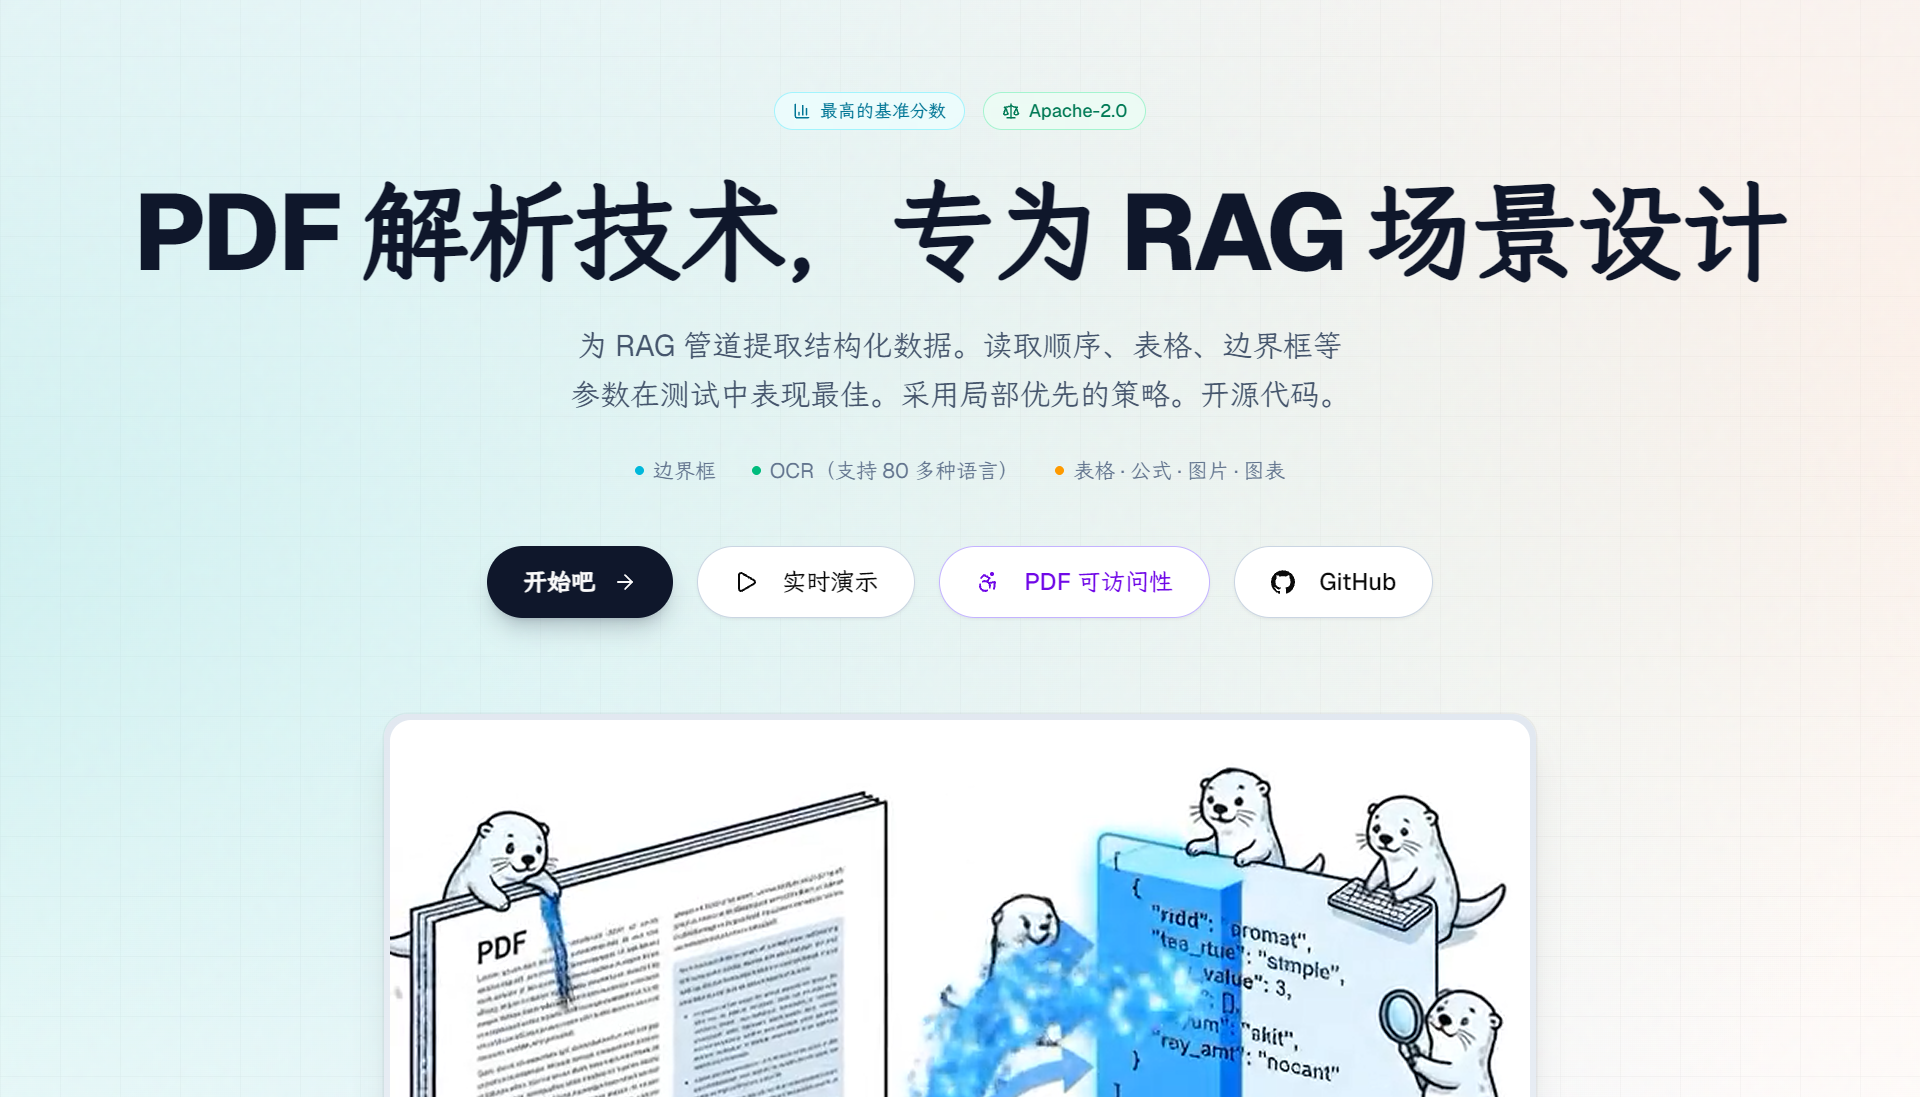
OpenDataLoader PDF 是 opendataloader-project 出品的 Apache-2.0 开源软件,定位是把任意 PDF 转成 AI 可读的数据:输出 Markdown、带 bounding box 坐标的 JSON 和 HTML,喂给 RAG 检索与大模型 pipeline。项目托管在 GitHub,数据抽取、版面分析、自动打标到 Tagged PDF 全部免费,还提供 Python、Node.js、Java 三套 跨平台应用 SDK。用途收拢成两条:给 AI 数据流水线做抽取,以及给企业 PDF 做无障碍自动化。
场景痛点
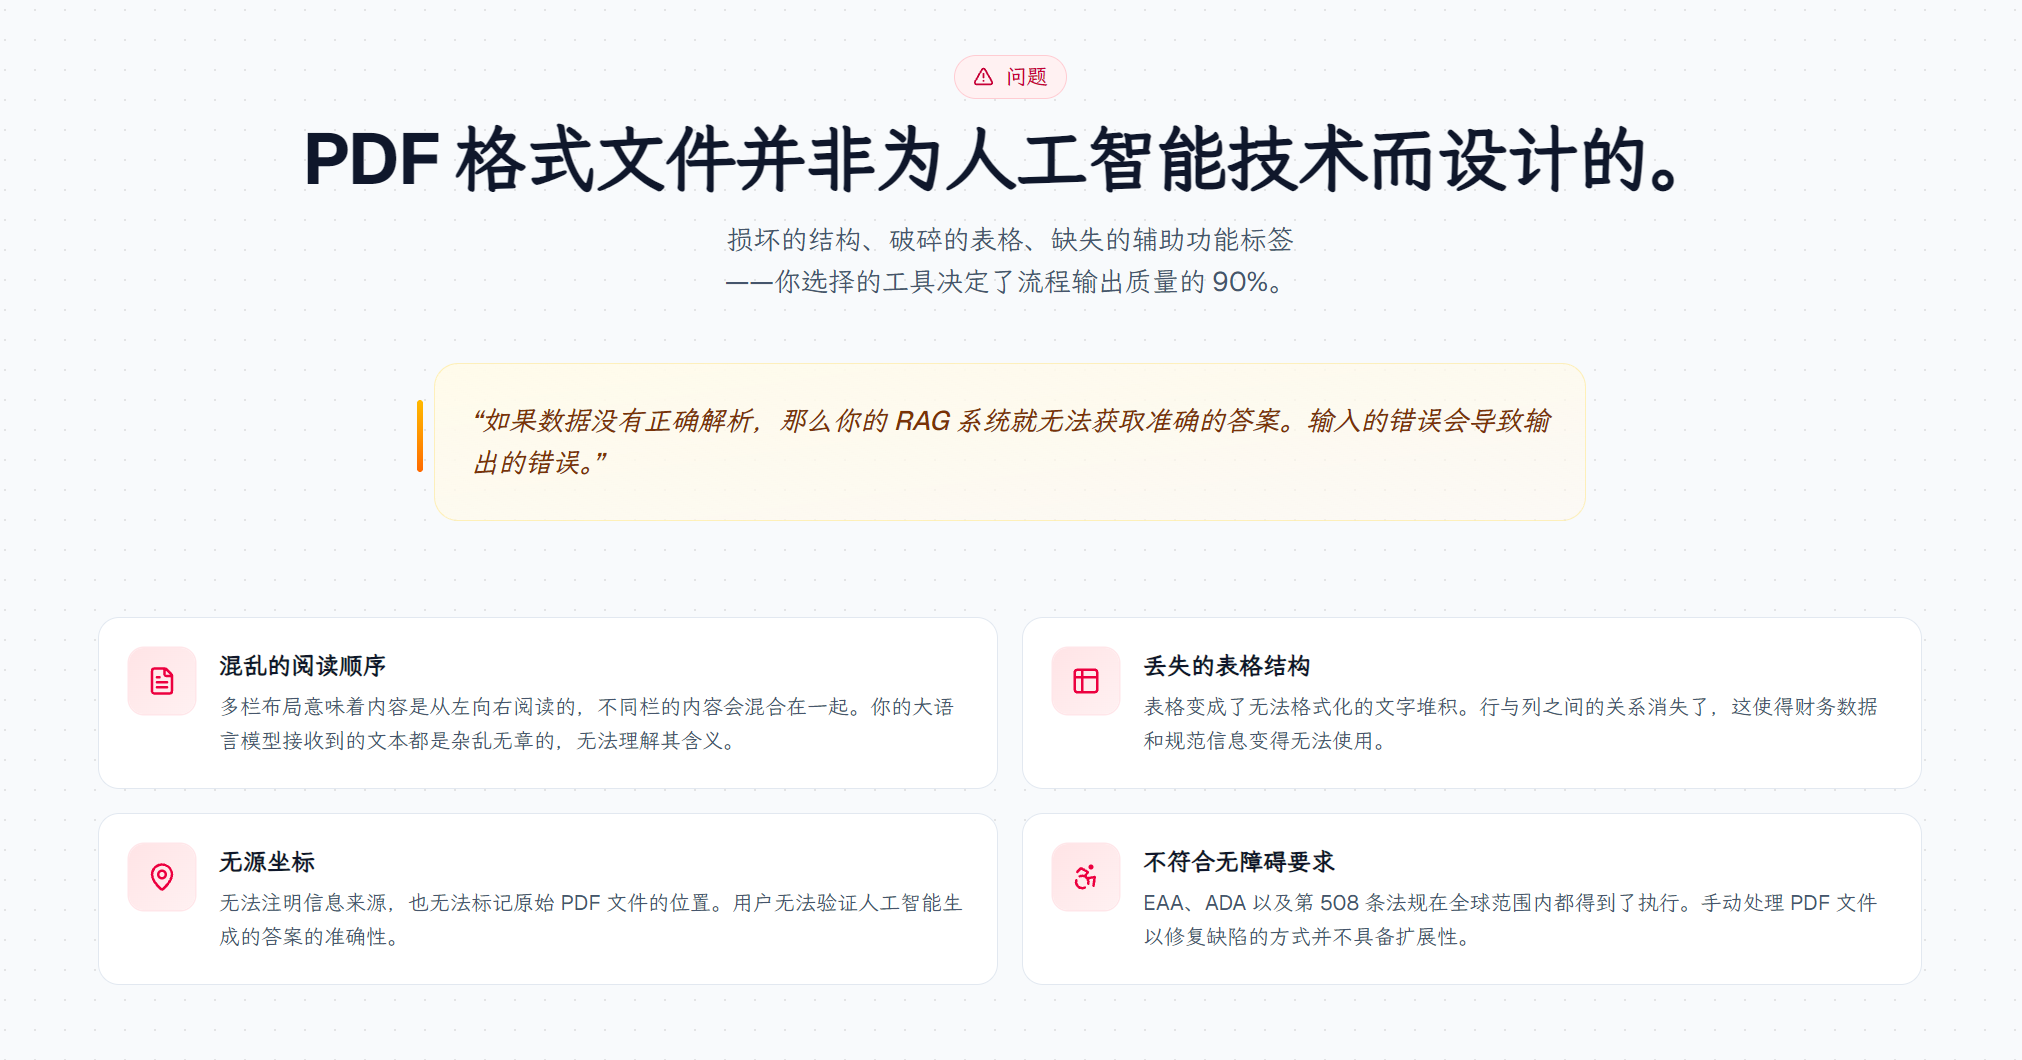
做 RAG 的人都清楚,PDF 是知识库喂数最难啃的一环:多栏论文阅读顺序乱、嵌套表格被拆成碎行、扫描件根本没有文本层,转出来的 Markdown 一塌糊涂,进不了知识管理系统,大语言模型拿到的是废数据。另一条线上,欧盟 EAA、美国 ADA 与 Section 508 现在强制企业 PDF 做无障碍,人工修复一份要 50 到 200 美元,没法规模化。两边的共同诉求,是稳定、可批量、坐标可溯源。
主要功能特点
DeepTutor 是一个智能体原生的学习工作区,将辅导、研究、创作和练习连接在一个可扩展的系统中。
- 一个运行时,多种学习模式 — Chat、Quiz、Research、Visualize、Solve、Mastery Path、Reading 等共享会话上下文,同时保留为特定用途打造的工作流。
- 互联的学习工作区 — 主页、学习和资源将 Chat、Books、Reading、Practice、Task Board、Calendar 与学习笔记本连接起来,共享素材、进度和学习上下文。
- 有据可依的知识与阅读 — 使用 LlamaIndex、PageIndex、GraphRAG 或 LightRAG 构建版本化资料库,连接外部知识来源,并在文档、视频和音频旁学习,获得链接至来源的引用。
- Partners 与子智能体 — 调用 Claude Code、Codex 和 Grok CLI 等实时智能体,导入过往对话,或运行拥有独立记忆、资源和 IM 渠道的持久 Partners。
- 可审计的记忆 — L1 追踪、L2 事实和 L3 综合让个性化透明可编辑,并可在 Memory Graph 中审计证据链接。
- 设计上可扩展 — 通过同一个智能体原生运行时添加人格预设、内置或社区技能、MCP 服务、CLI 应用和生成模型。
三种输出格式,每个元素带坐标
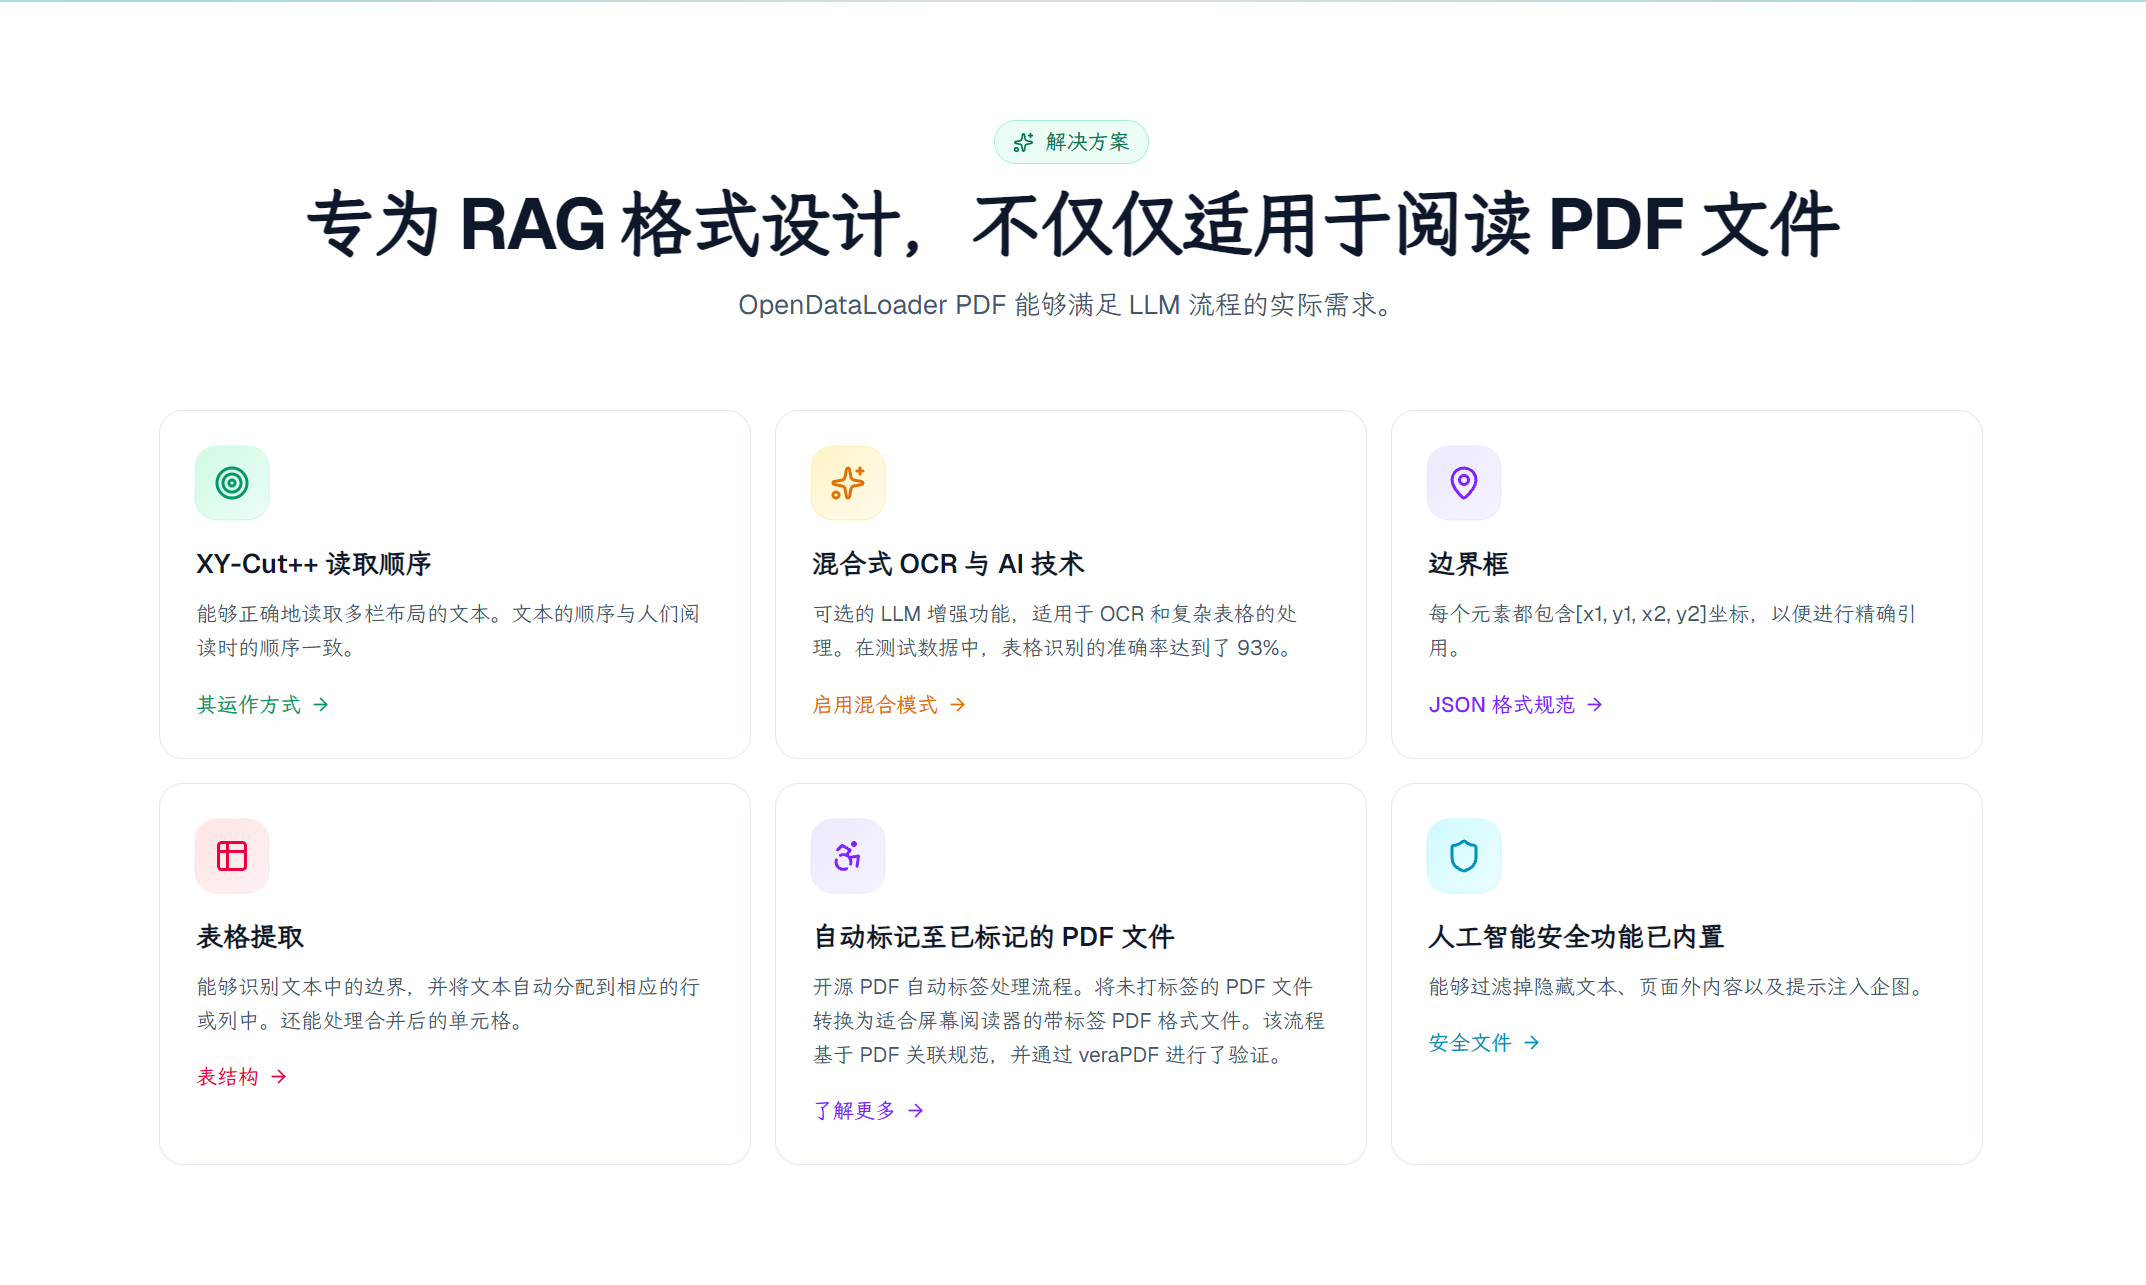
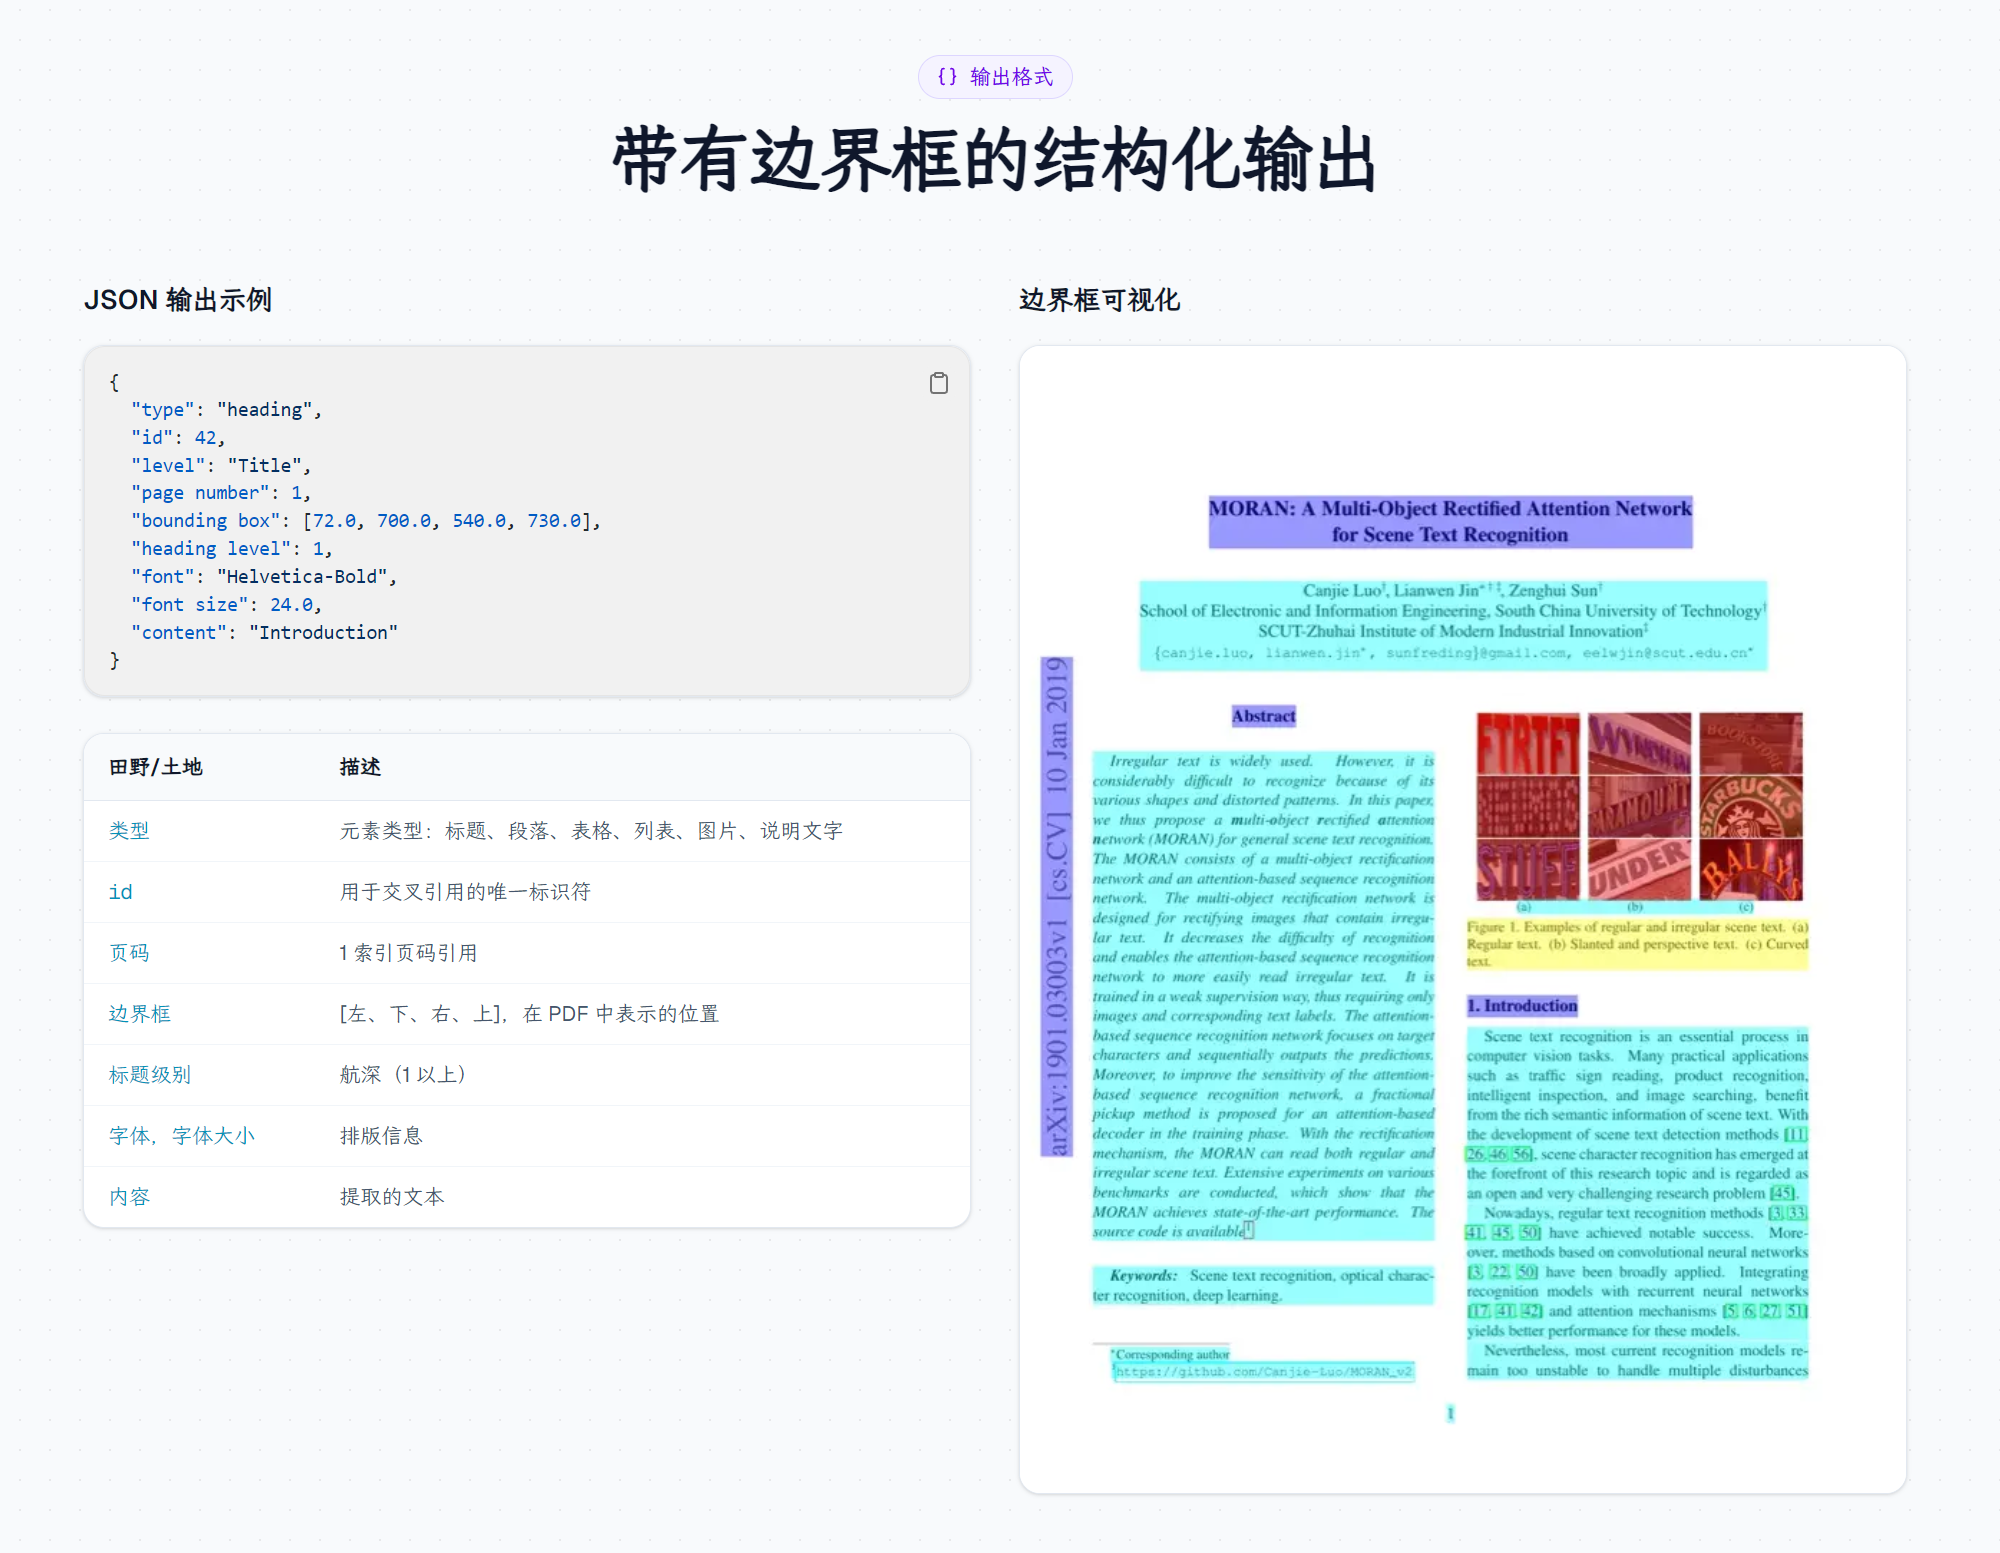
一行命令把 PDF 转成 Markdown、JSON 或 HTML,JSON 里每个文本块、表格、图片都带 bounding box 坐标,引用时能指回原页位置做溯源。输出的 Markdown 保留标题层级与列表结构,LangChain 已集成,可直接接进 PDF工具类检索流水线,页眉页脚和水印自动过滤。
本地解析加混合 AI 双模式
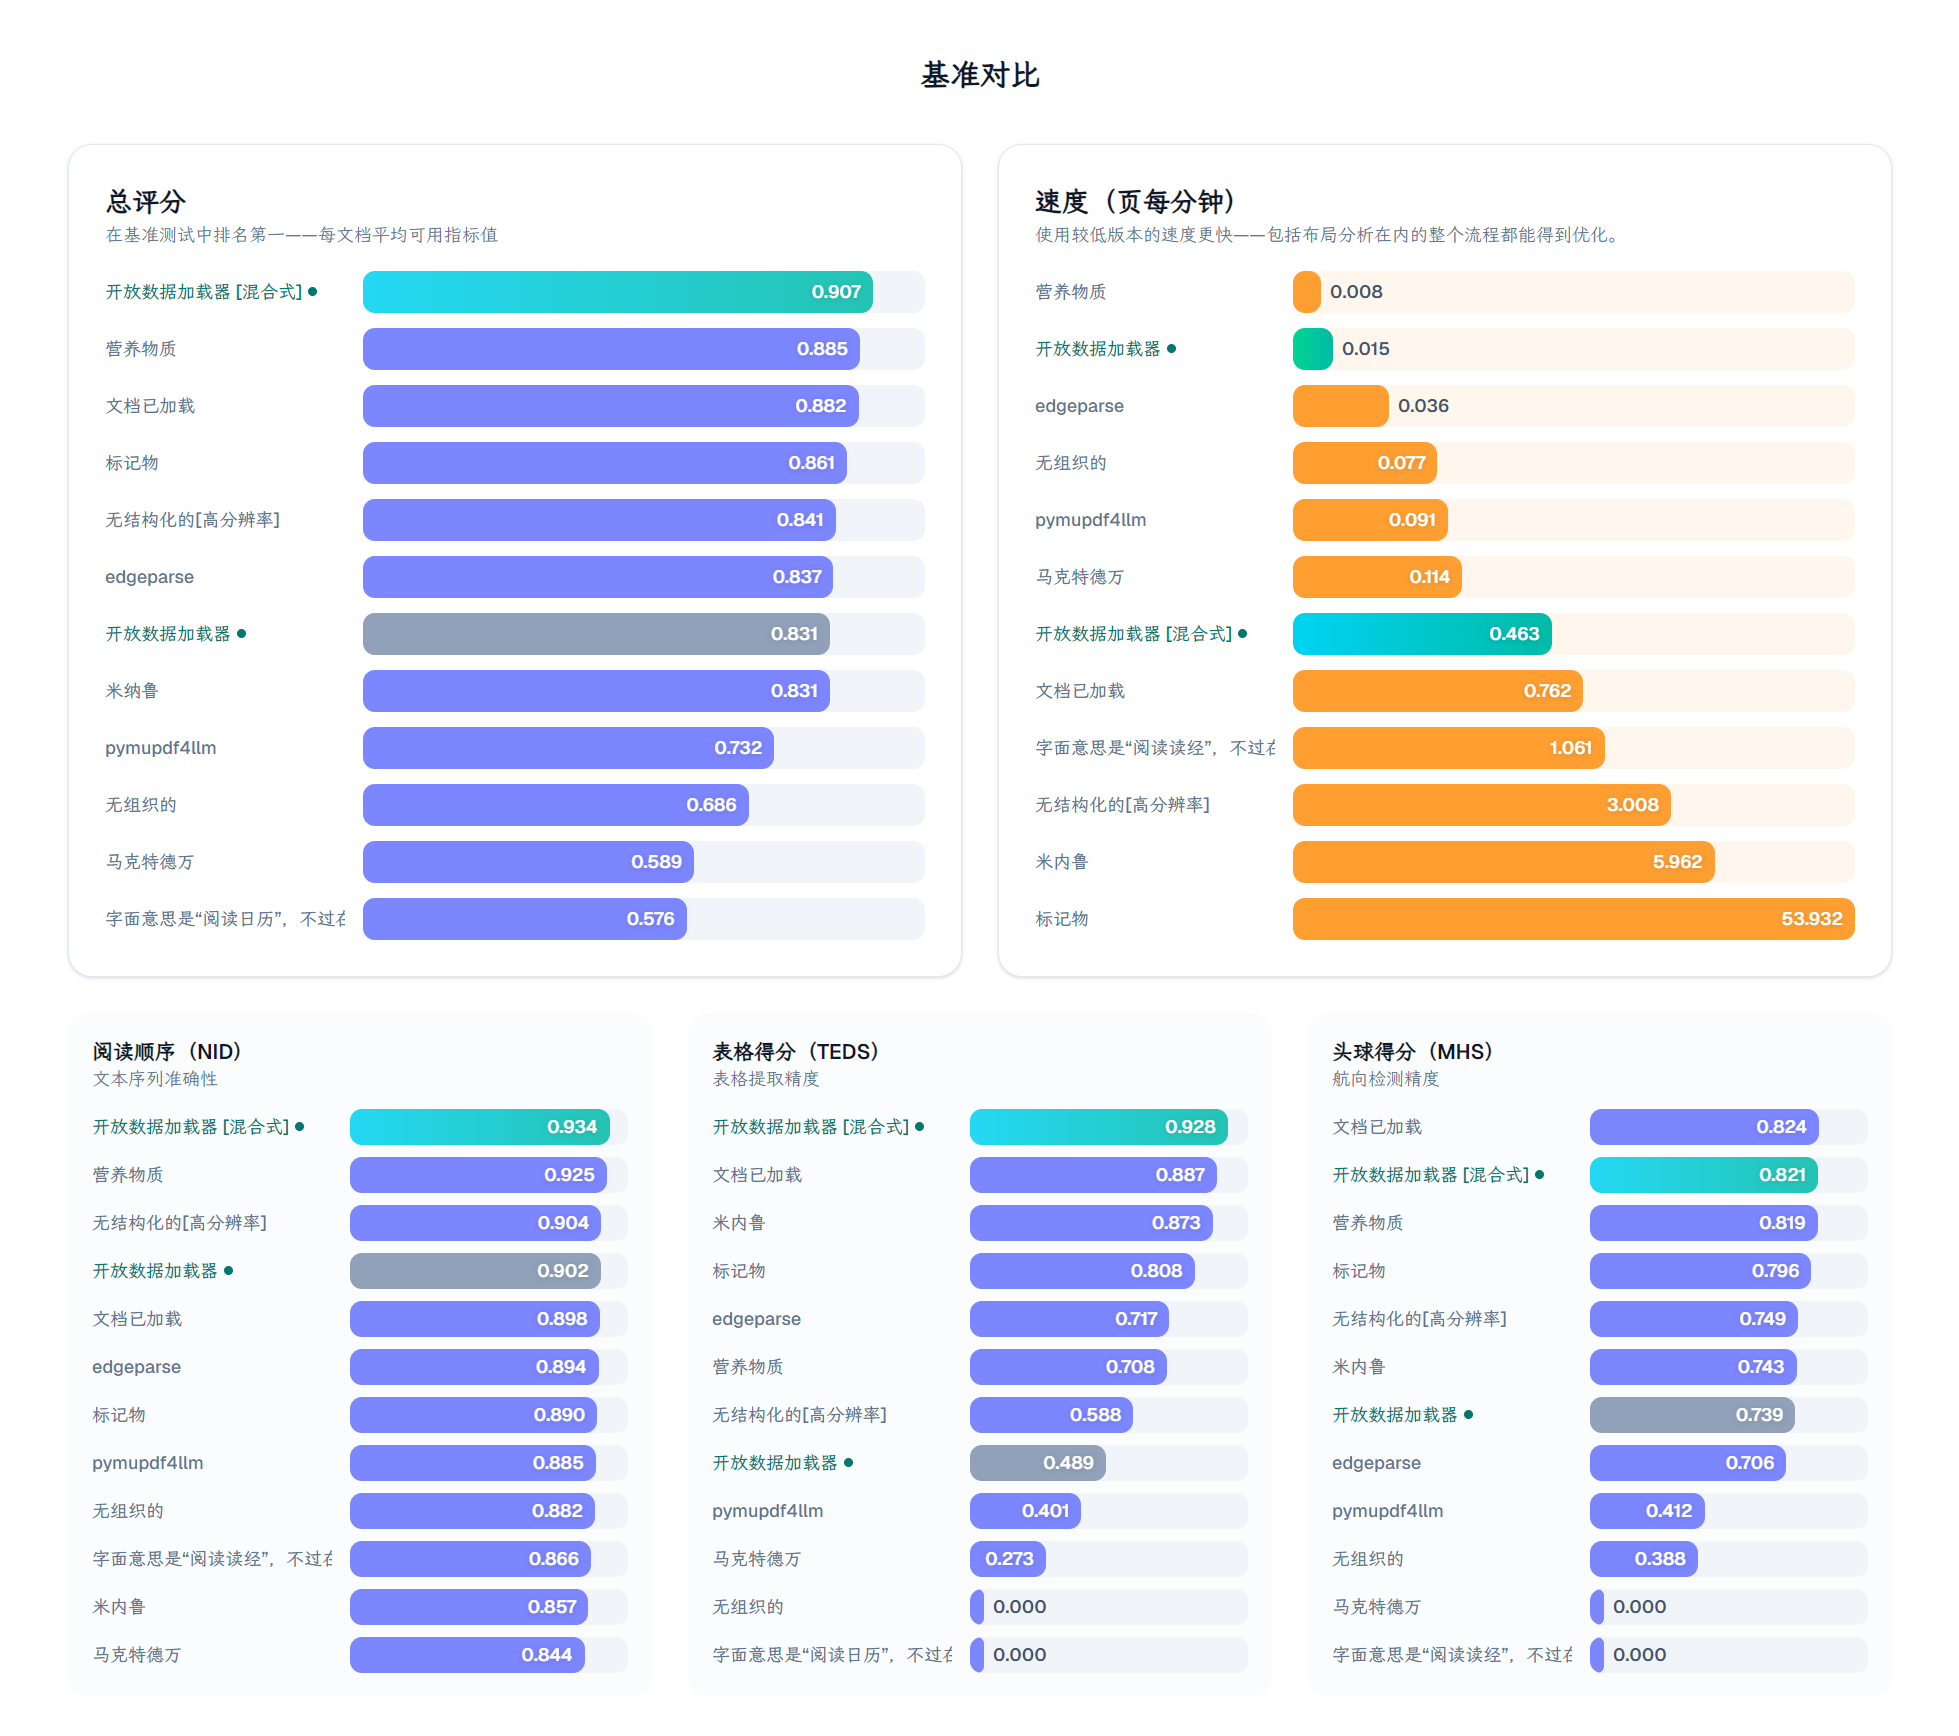
普通数字 PDF 走本地 Java 解析,官方基准里纯本地约 0.015 秒一页,可复现,数据不出本机,这是它在隐私保护场景的卖点。复杂表格、扫描件或公式页路由到 AI 后端,官方称表格准确率相对本地提升约 90%。Python 里可用 HybridServer 自动启停后端,不必开两个终端,是批量流水线常用的效率工具做法。
表格公式与八十多种语言 OCR
无边框或嵌套表格在混合模式下还原成结构化表格,扫描件走 OCR,支持 EasyOCR、RapidOCR、Tesseract、Apple Vision 等引擎,覆盖 80 多种语言。公式用 –enrich-formula 抽成 LaTeX,图表由 AI 生成描述。OCR识别能力让老论文和扫描年报也能进同一条流水线。
自动打标生成 Tagged PDF
Tagged PDF 带结构标签,屏幕阅读器才能逐段朗读。官方称它是首个端到端把未打标 PDF 自动打成 Tagged PDF 的工具,与 veraPDF 开发方 Dual Lab、PDF Association 合作,遵循 Well-Tagged PDF 规范并自动校验。对过合规的文档工程师实用,属于 实用软件里少见的无障碍方向。
三行代码批量转换
装好 Java 11 以上环境后,pip install -U opendataloader-pdf,混合模式加 hybrid 后缀。convert 一次传入多个文件或目录、指定输出目录与格式即可。每次 convert 会拉起 JVM 进程,批量任务应一次性传进同一调用,别循环单文件。它是门槛很低的软件工具,也常进工具推荐清单。
Apache-2.0 核心免费,企业版补无障碍导出
数据抽取、版面分析、自动打标核心能力全部 Apache-2.0 开源,不需要 GPU。企业版只做两件事:把 Tagged PDF 导出成 PDF/UA-1/UA-2 规范文件,以及可视化无障碍修复工作室。不处理 Word、Excel、PPT。协议干净的开源项目,商用没有 copyleft 传染风险,比 GPL 类工具省心。
官方基准对比,混合模式得分领先
官方 opendataloader-bench 在 200 份真实 PDF 上打分,混合模式总分 0.907,约 0.463 秒一页;同场 docling 0.882、marker 0.861、unstructured 0.841、mineru 0.831。数字以官方口径为准,接入前建议拿自己的样本复测,AI工具赛道卷得很快。
项目地址
官网 访问
GitHub 访问
下载地址
https://pan.quark.cn/s/716b443d1a10
https://www.guangyapan.com/s/1966871850408976462_aeWhI5wocgzRgCO6 (光鸭新用户注册福利:永久免费空间:所有新用户注册即可解锁 2TB 永久免费存储空间,无需额外任务或付费)
相关推荐