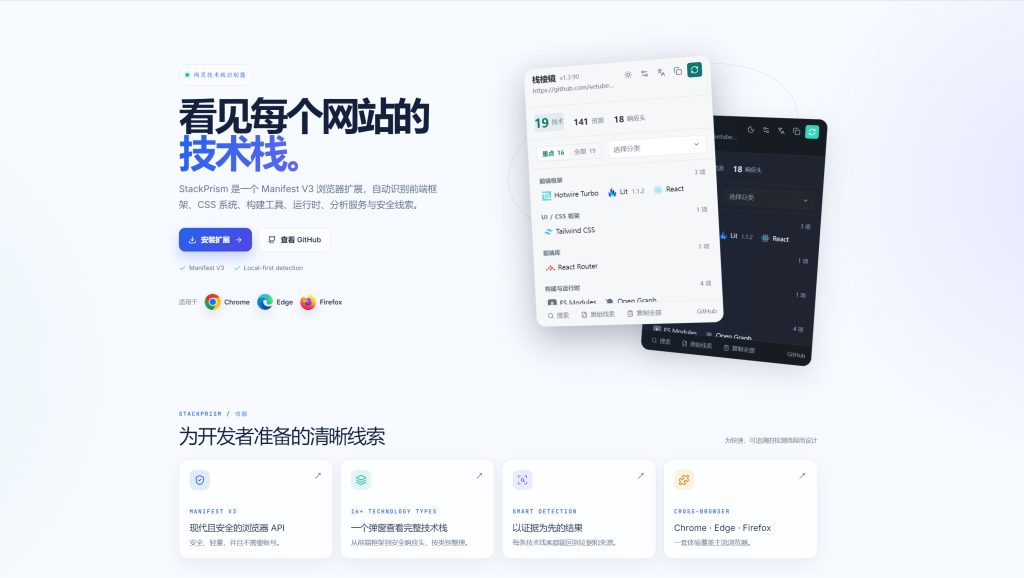
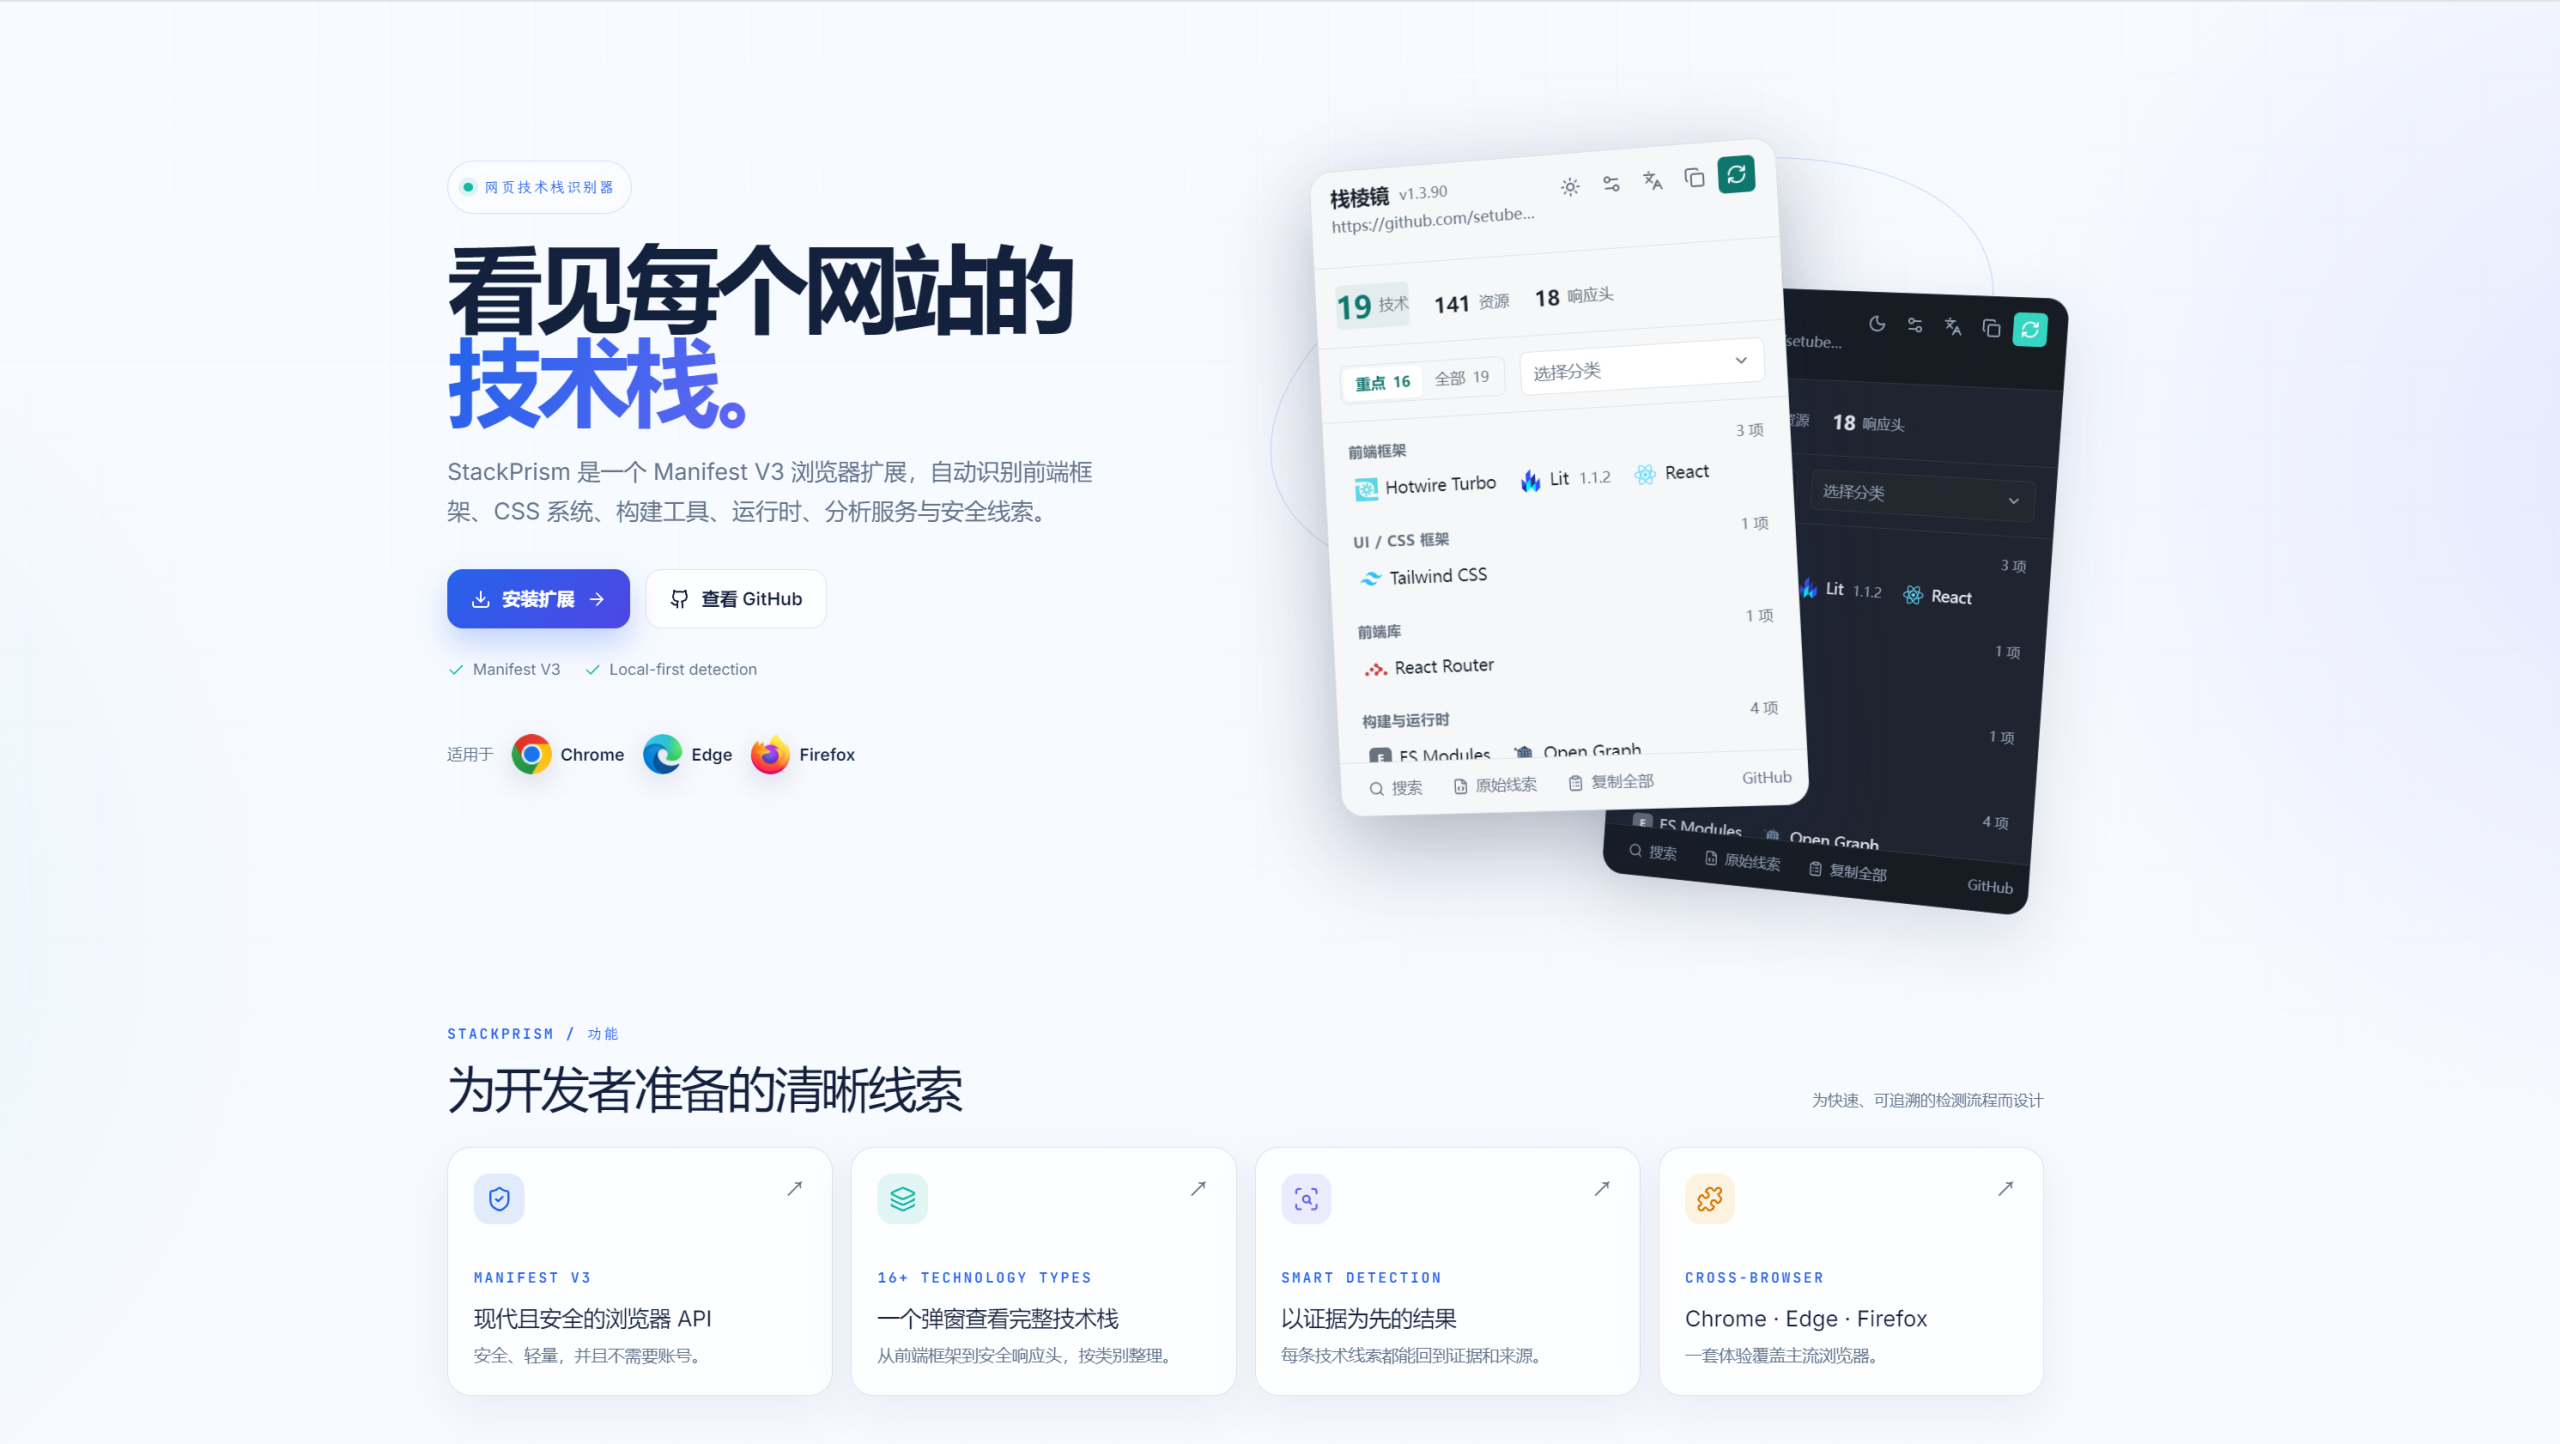
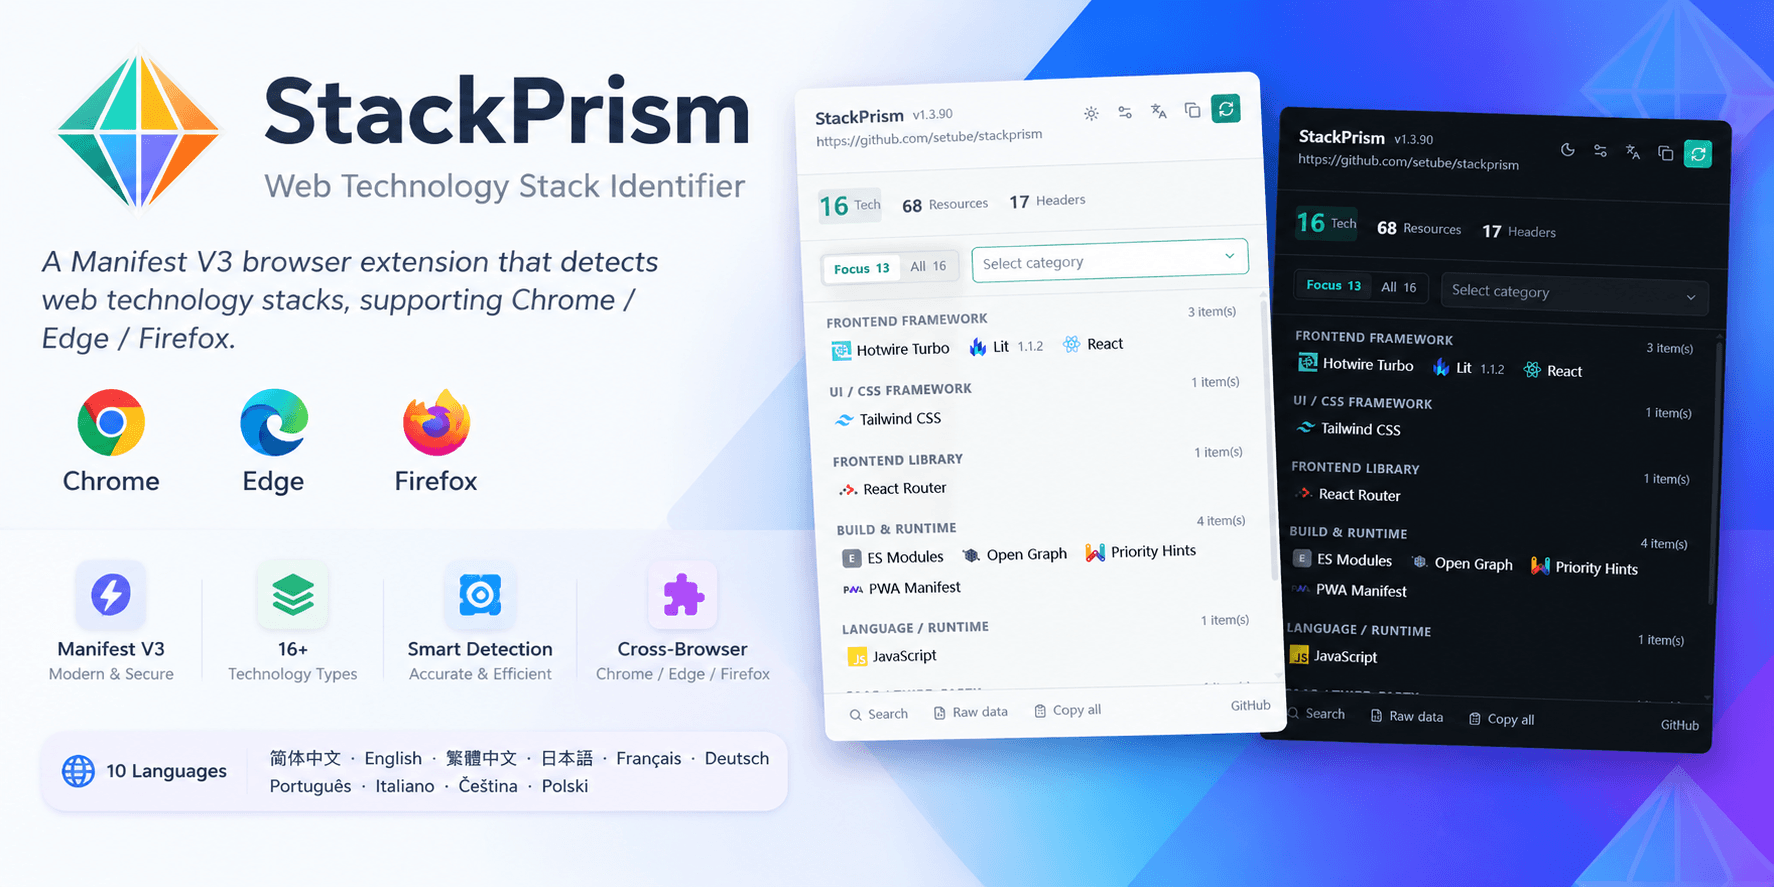
StackPrism 是一款基于 Manifest V3 的浏览器扩展,由开发者 setube 以 MIT 协议开源,支持 Chrome、Edge 和 Firefox。它在浏览器里常驻,打开任意网页就能识别这个站点用了哪些前端框架、后端服务、内容系统和第三方服务。和多数只看 HTML 资源地址的同类工具不同,它同时跑四路独立检测通道,把结果合并去重后按五十多个类目分组,还会主动标出伪造响应头。项目在 GitHub 上公开,属于 开源软件 里给 前端开发 和技术选型做参考的一类,也是做 Web 调研时常用的 资源发现 入口。
场景痛点
做前端或者调研竞品时,看到一个顺眼的站点,总想知道它背后用了什么框架、架在哪个 CDN 上、埋了哪家统计。开 DevTools 翻 Network,一堆脚本和样式文件名混在一起,光靠资源地址猜不准;页面交互之后才懒加载的组件,初次抓取又看不到。有些站还会伪造响应头,或者把第三方依赖打进打包产物里,常规嗅探要么漏报要么乱报,结果堆成一团没法直接用。StackPrism 把这些证据来源拆成四路并行收集,再合并去重,遇到伪造头还会单独降级标注,省掉了逐个资源文件人肉猜测的功夫。
主要功能特点
四路检测通道并行收集
多数同类工具只扫 HTML 资源地址,StackPrism 同时跑四路:加载时注入脚本扫描 DOM、全局变量和 CSS 类名;服务工作线程监听响应头,抓取主文档和 iframe 的响应头;内容脚本用观察者接口累积交互后才加载的资源;后台再异步抓主包开头,靠版权注释识别打进 main、vendor 包里的第三方依赖。
结果合并去重与反误报
四路结果汇总后会合并去重,归入五十多个类目,同时主动抑制伪造响应头、自指检测和模糊误报。当同一个页面同时出现四个以上互不相同的身份头时,扩展会判断这可能是蜜罐或伪造响应,把相关类目降到低置信并给出警告。后端识别本来就不完整,很多站隐藏 Server 和 X-Powered-By 头,结果以线索加置信度的形式呈现,需要和其他信号一起看。
数据驱动的规则体系
识别不靠硬编码,而靠 JSON 规则文件:页面规则处理源码、DOM 和资源地址,头部规则处理响应头和 Cookie,另有自托管抑制规则在访问主流技术官网时跳过同名误报。仓库里有两千多条规则、五十多个类目。构建时预编译器给每条规则注入提示片段和合并正则,运行时只评估候选命中,想支持新框架改 JSON 文件即可。
MV3 服务工作线程架构
扩展采用 Manifest V3 的服务工作线程,没有常驻后台进程,事件驱动触发,内存占用较低。弹窗和设置页跟随浏览器语言自动切换,支持简繁中文、日语、法语、德语、葡萄牙语、意大利语、捷克语和波兰语共九种,也可在弹窗头部手动切换。这是一款轻量的 开发者工具,做竞品分析和技术摸底时挂着即可,不打断日常浏览。
广覆盖的识别维度
识别范围横跨前端、后端、内容和第三方服务:前端有框架、UI 库和构建运行时,后端有 Web 服务器、CDN 和托管,内容侧覆盖 CMS、电商和 RSS,第三方包括 SaaS、APM、AI 模型、社交登录和支付;营销和安全侧还能识别广告、统计、WAF、HTTPS 版本和 Cookie 同意条。结果里的技术名会链接到官网,做 效率工具 式的快速查阅时点一下就能跳转。
实验性 CLI 与 SDK
除了浏览器扩展,它还提供实验性的 Node.js CLI 和 SDK,复用同一套检测器内核,用 bun run build:sdk 构建,目前尚未发布到 npm。它面向想把技术栈识别嵌进脚本或流水线的开发者,属于预览阶段能力。日常用商店版扩展更省事,命令行适合愿意折腾的 软件工具 用户,也是 工具推荐 里偏极客向的一类。
官方网站
官网 访问
GitHub 访问
Chrome 应用商店 访问
Edge 加载项 访问
Firefox 附加组件 访问
下载地址
https://pan.quark.cn/s/95e4e1d462e2
相关推荐
Obsidian Quick Write AI Chat – Chrome 里写 Markdown,直接落到本地 Vault
 2026-09-10
Linkly AI Clipper – 网页一键转成排版干净的 Markdown|Bilibili 等视频字幕和转写保存
2026-08-26
SwiftTab Pro – Chrome 标签页缩略图快速切换预览插件丨横向卡片条、网格、卡片堆叠三种布局
2026-08-25