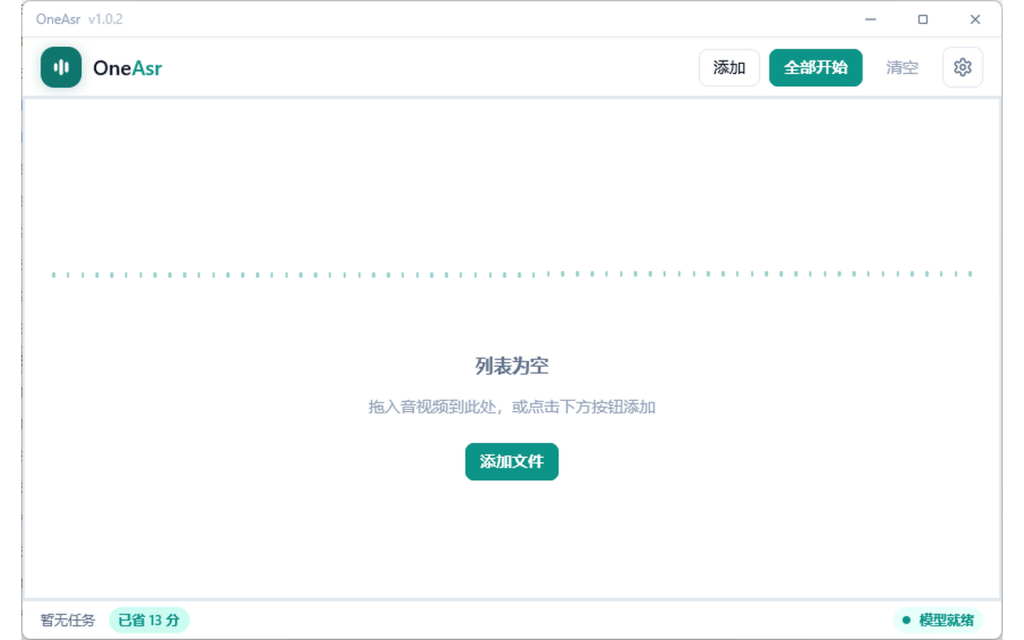
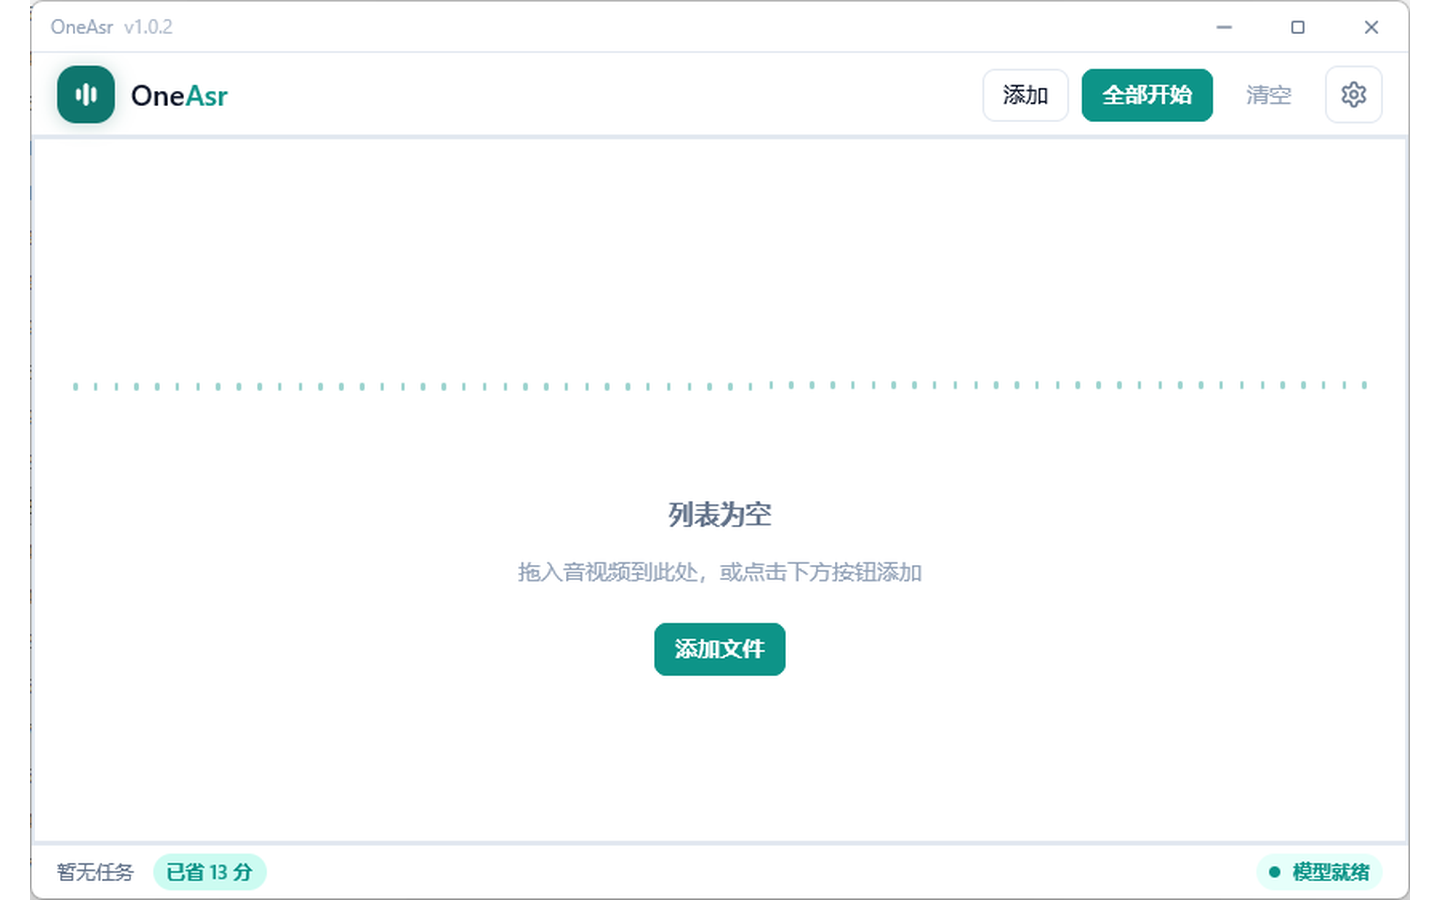
OneAsr 是一个开源的软件工具,在本地把音频和视频批量转成 SRT 或 TXT 字幕。它基于 Qwen3-ASR 加 ForcedAligner,Windows、Linux、macOS 都有包,转写和对齐全程在你机器上跑。作为一个开源软件,除了首次从 ModelScope 下载模型需要联网,之后完全离线。
场景痛点
给视频加字幕这件事,在线工具都一个德行:把音频传到人家服务器上,按分钟计费,转完时间轴还是整段整段的猜,对不上口型。更别扭的是录的是访谈、会议、内部素材,根本不放心传到云上。做视频处理的人都有这种矛盾:想要字幕准,又不想把素材交出去。
主要功能特点
- 完全本地:转写与对齐都在本机,下完模型可断网用
- 批量队列:一次丢多个文件,进度与阶段一目了然
- 时间轴可靠:ForcedAligner 词级对齐 + 智能断句,不是整段估时间
- 11 种语言:中文普通话、English、粤语、日本語、한국어、Français、Deutsch、Italiano、Español、Português、Русский(需手动指定,不自动检测)
- 双规格 ASR:0.6B(更快 / 省显存)· 1.7B(更准 / 更吃资源)
- 输出可选:SRT / TXT 可同时选,默认与视频同目录
- 简繁可选:原文 / 简体 / 繁体(仅中文、粤语生效,不影响时间轴)
- 人声分离(可选):内置 HTDemucs v4,带 BGM / 噪声时先压掉背景音
- GPU 加速:NVIDIA / AMD / Intel / Mac M 芯片;无独显自动走 CPU
本地离线,不上传云端
转写和对齐都在本机完成,模型下好之后拔网线照样跑。访谈、会议、内部培训这类不能外传的素材,终于可以安心理直气壮地跑字幕。这种把本地AI模型真正跑在自己机器上的做法,比把音频丢给云 API 踏实。
词级对齐,时间轴准
不是整段猜时间,而是 ForcedAligner 做词级对齐,再智能断句。字幕和口型对得上,不用你在时间轴上手动拉半天。这一点是它和那些「整段一句话扔进去、给个大概时间」的在线工具最大的差别。
批量队列,丢进去就不管
一次拖一堆文件进来,进度和当前阶段始终可见。转写长片、批量处理课程录像、播客切片段,都不用守在旁边。作为桌面软件,它把「一次转一条」做成了队列。
11 种语言,中英繁简可选
支持中文普通话、粤语、英语、日语、韩语、法、德、意、西、葡、俄 11 种源语言(手动指定,不自动检测)。中文和粤语还能选原始字形、简体、繁体。做自媒体切多语言版本的人,这个覆盖够用。
人声分离,压着 BGM 也能转
内置 HTDemucs v4,转写前先把背景音和人声拆开。背景音乐吵、环境噪音大的素材,开了人声分离再转,准确率明显上一个台阶。
双模型尺寸,GPU 自动加速
Qwen3-ASR 有 0.6B(快、显存小)和 1.7B(准、吃资源)两档;NVIDIA、AMD、Intel、Apple Silicon 都能 GPU 加速,没独显自动退到 CPU。ffmpeg 已经打包进每个 release,不用自己配。在跨平台应用这条线上,Windows、macOS Apple Silicon、Linux 都有安装包。
简易使用教程
在实用软件里,它属于「装完下模型就能用」那一挂:
- 去 Release 页下对应平台的安装包或便携版(Windows 有 Installer 和 Portable,Linux 有 .deb 和 tar.gz,macOS 是 DMG)。
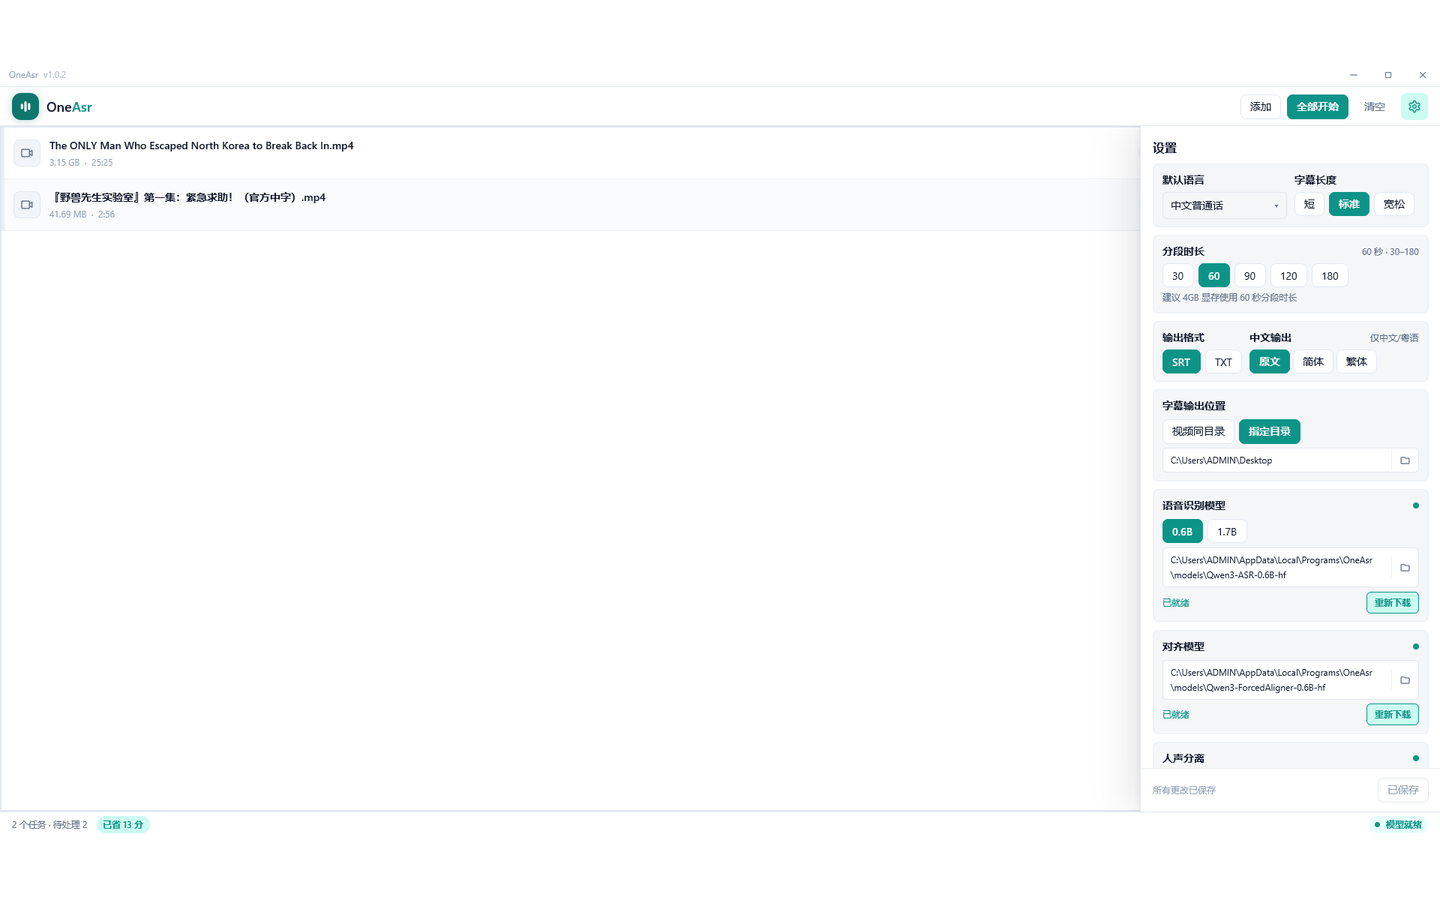
- 首次打开进 Settings,下载 ASR 模型(推荐先 0.6B)和 ForcedAligner(必装),模型从 ModelScope 断点续传。
- 选源语言(粤语记得选「粤语」,别选成普通话),拖音视频文件进队列,点开始。
- 输出默认 SRT 和 TXT,存在视频同目录下;中文字形可选原始/简体/繁体。
- 命令行党用 oneasr-cli transcribe –input video.mp4 –language zh –output out.srt。
安装包不含权重,首次在设置里从 ModelScope 下载(可断点续传):
| 组件 | 约体积 | 说明 |
|---|---|---|
| Qwen3-ASR-0.6B-hf | ~1.6 GB | 默认推荐 |
| Qwen3-ASR-1.7B-hf | ~4.1 GB | 更高精度 |
| Qwen3-ForcedAligner-0.6B-hf | ~1.8 GB | 必需,所有 ASR 共用 |
| HTDemucs v4 人声权重 | ~84 MB | 可选 |
个人使用感受
我用下来最直接的感受是「终于不用把素材传出去了」。以前转访谈视频字幕,要么用云 API 按分钟付费,要么用开源方案但要配 Python 环境;OneAsr 装好、下个模型,拖文件进去就跑,词级对齐出来的时间轴比我手动拉的还准。人声分离这个功能也实用——我那个压着 BGM 的播客片段,开了分离之后识别错字率明显降下来。
也得说清它的门槛:模型不小(0.6B 约 1.6GB,加对齐器和人声模型总共 3.5–6GB),第一次下载要等;显存建议 4GB 以上跑 0.6B,没独显能跑但慢;语言要手动选,选错是最常见的失败原因;macOS 版未签名,首次打开要按说明放行。但如果你经常要给音视频加字幕、又受够了云 API 按分钟计费和上传素材的不踏实,这个把影音编辑流程整个搬到本地的开源工具,值得放进你的工具推荐清单,归在AI工具分类下。它没替你写文案,只是让你的音视频,终于能在不出这台电脑的前提下,得到一版时间轴对得上的字幕。
官方网站
GitHub https://github.com/eclipse005/OneAsr
下载地址
https://pan.quark.cn/s/62a00ee8bb66
https://www.guangyapan.com/s/1954753666950606897_aeWhI5wocgzRgCO6 (光鸭新用户注册福利:永久免费空间:所有新用户注册即可解锁 2TB 永久免费存储空间,无需额外任务或付费)
相关推荐
video-subtitle-generator 视频字幕生成器:Windows 本地 Whisper 批量转录与双语字幕工具
 2026-09-10
OnlyTranslate 只译 – 双语阅读浏览器扩展,只翻你正在读的内容,视频字幕翻译、本地 EPUB、PDF
2026-09-08