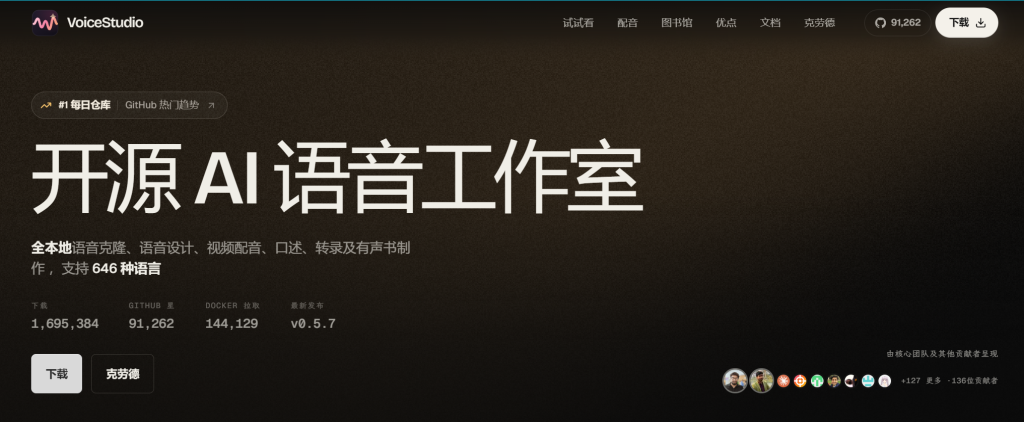
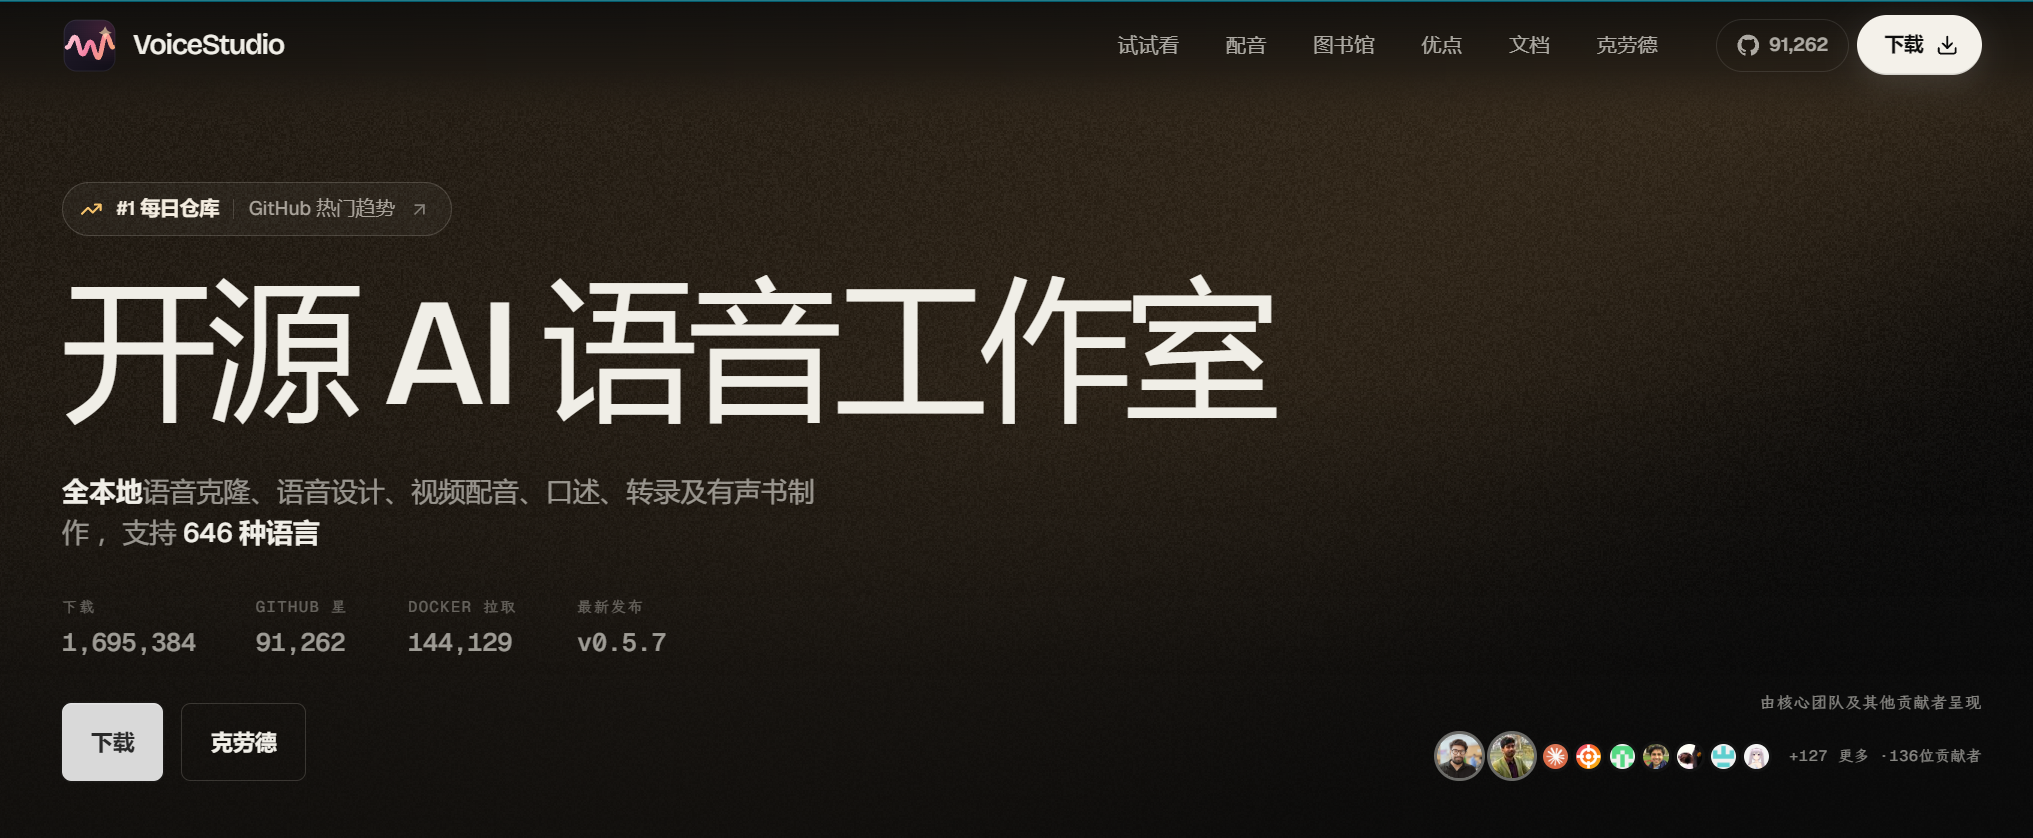
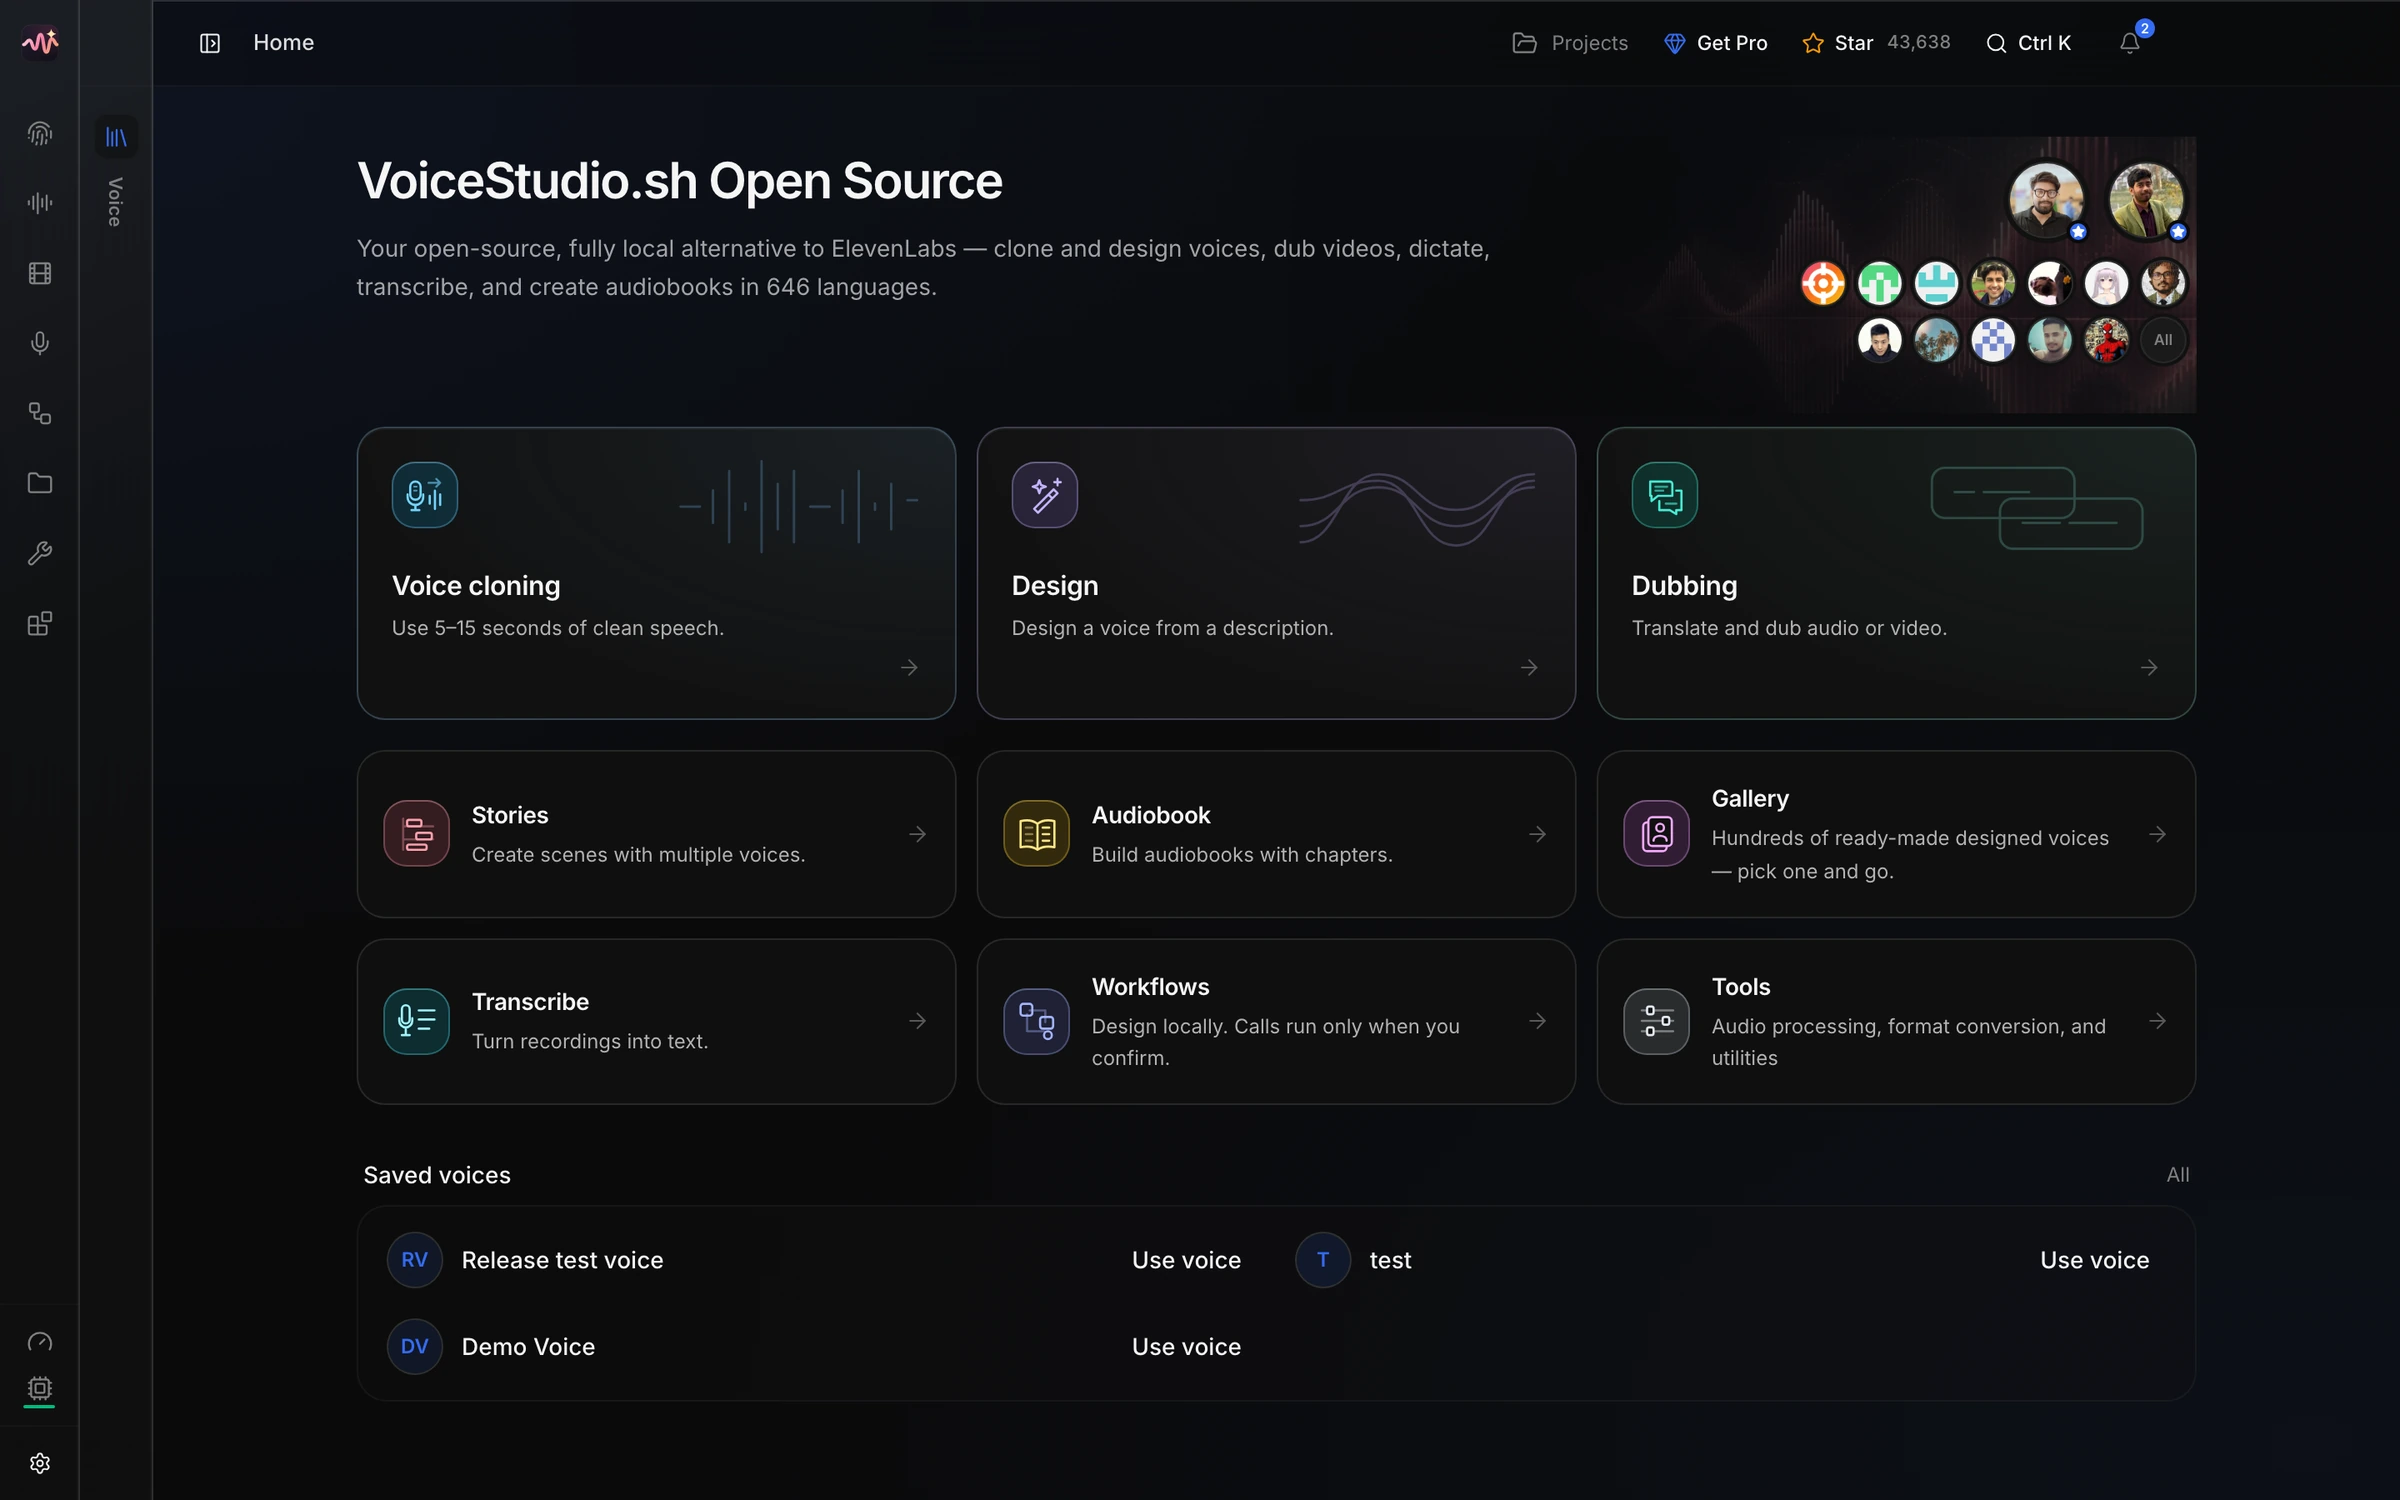
VoiceStudio 是开发者 Palash Debnath 创建、Shimul Debnath 参与核心开发的开源声音工作台,应用本身以 AGPL-3.0 协议发布。它把声音克隆、声音设计、视频配音、语音听写、转录与有声书创作收进同一个 Electron 桌面应用,官方口径支持 646 种语言。本地工作流默认在自己的硬件上运行,模型按需下载、装完即可离线生成,远程服务只是可选项,使用情况分析要经本人同意才开启。代码在 GitHub 上完整公开,作为一款把声音制作整条链路做进桌面的开源软件,它更像一个装在本机的声音工作室,而不是按月订阅的云端配音网页。
场景痛点
做视频、做播客、写长稿的人都绕不开声音这一关:自己录,嗓子状态和发音都不可控;请人配,等排期还要按分钟付费;给外语内容配中文旁白,逐句对时间轴是最磨人的重复活;开会采访的录音整理成文字,又得一句句敲。市面上这类音频处理工具不算少,但大多只做其中一环,或者素材得先传到别人的服务器;想找一个把这几件事拢到一起、数据还留在本机的效率工具,选择一直不多。
主要功能特点
声音克隆:选已有声音或录一段参考录音
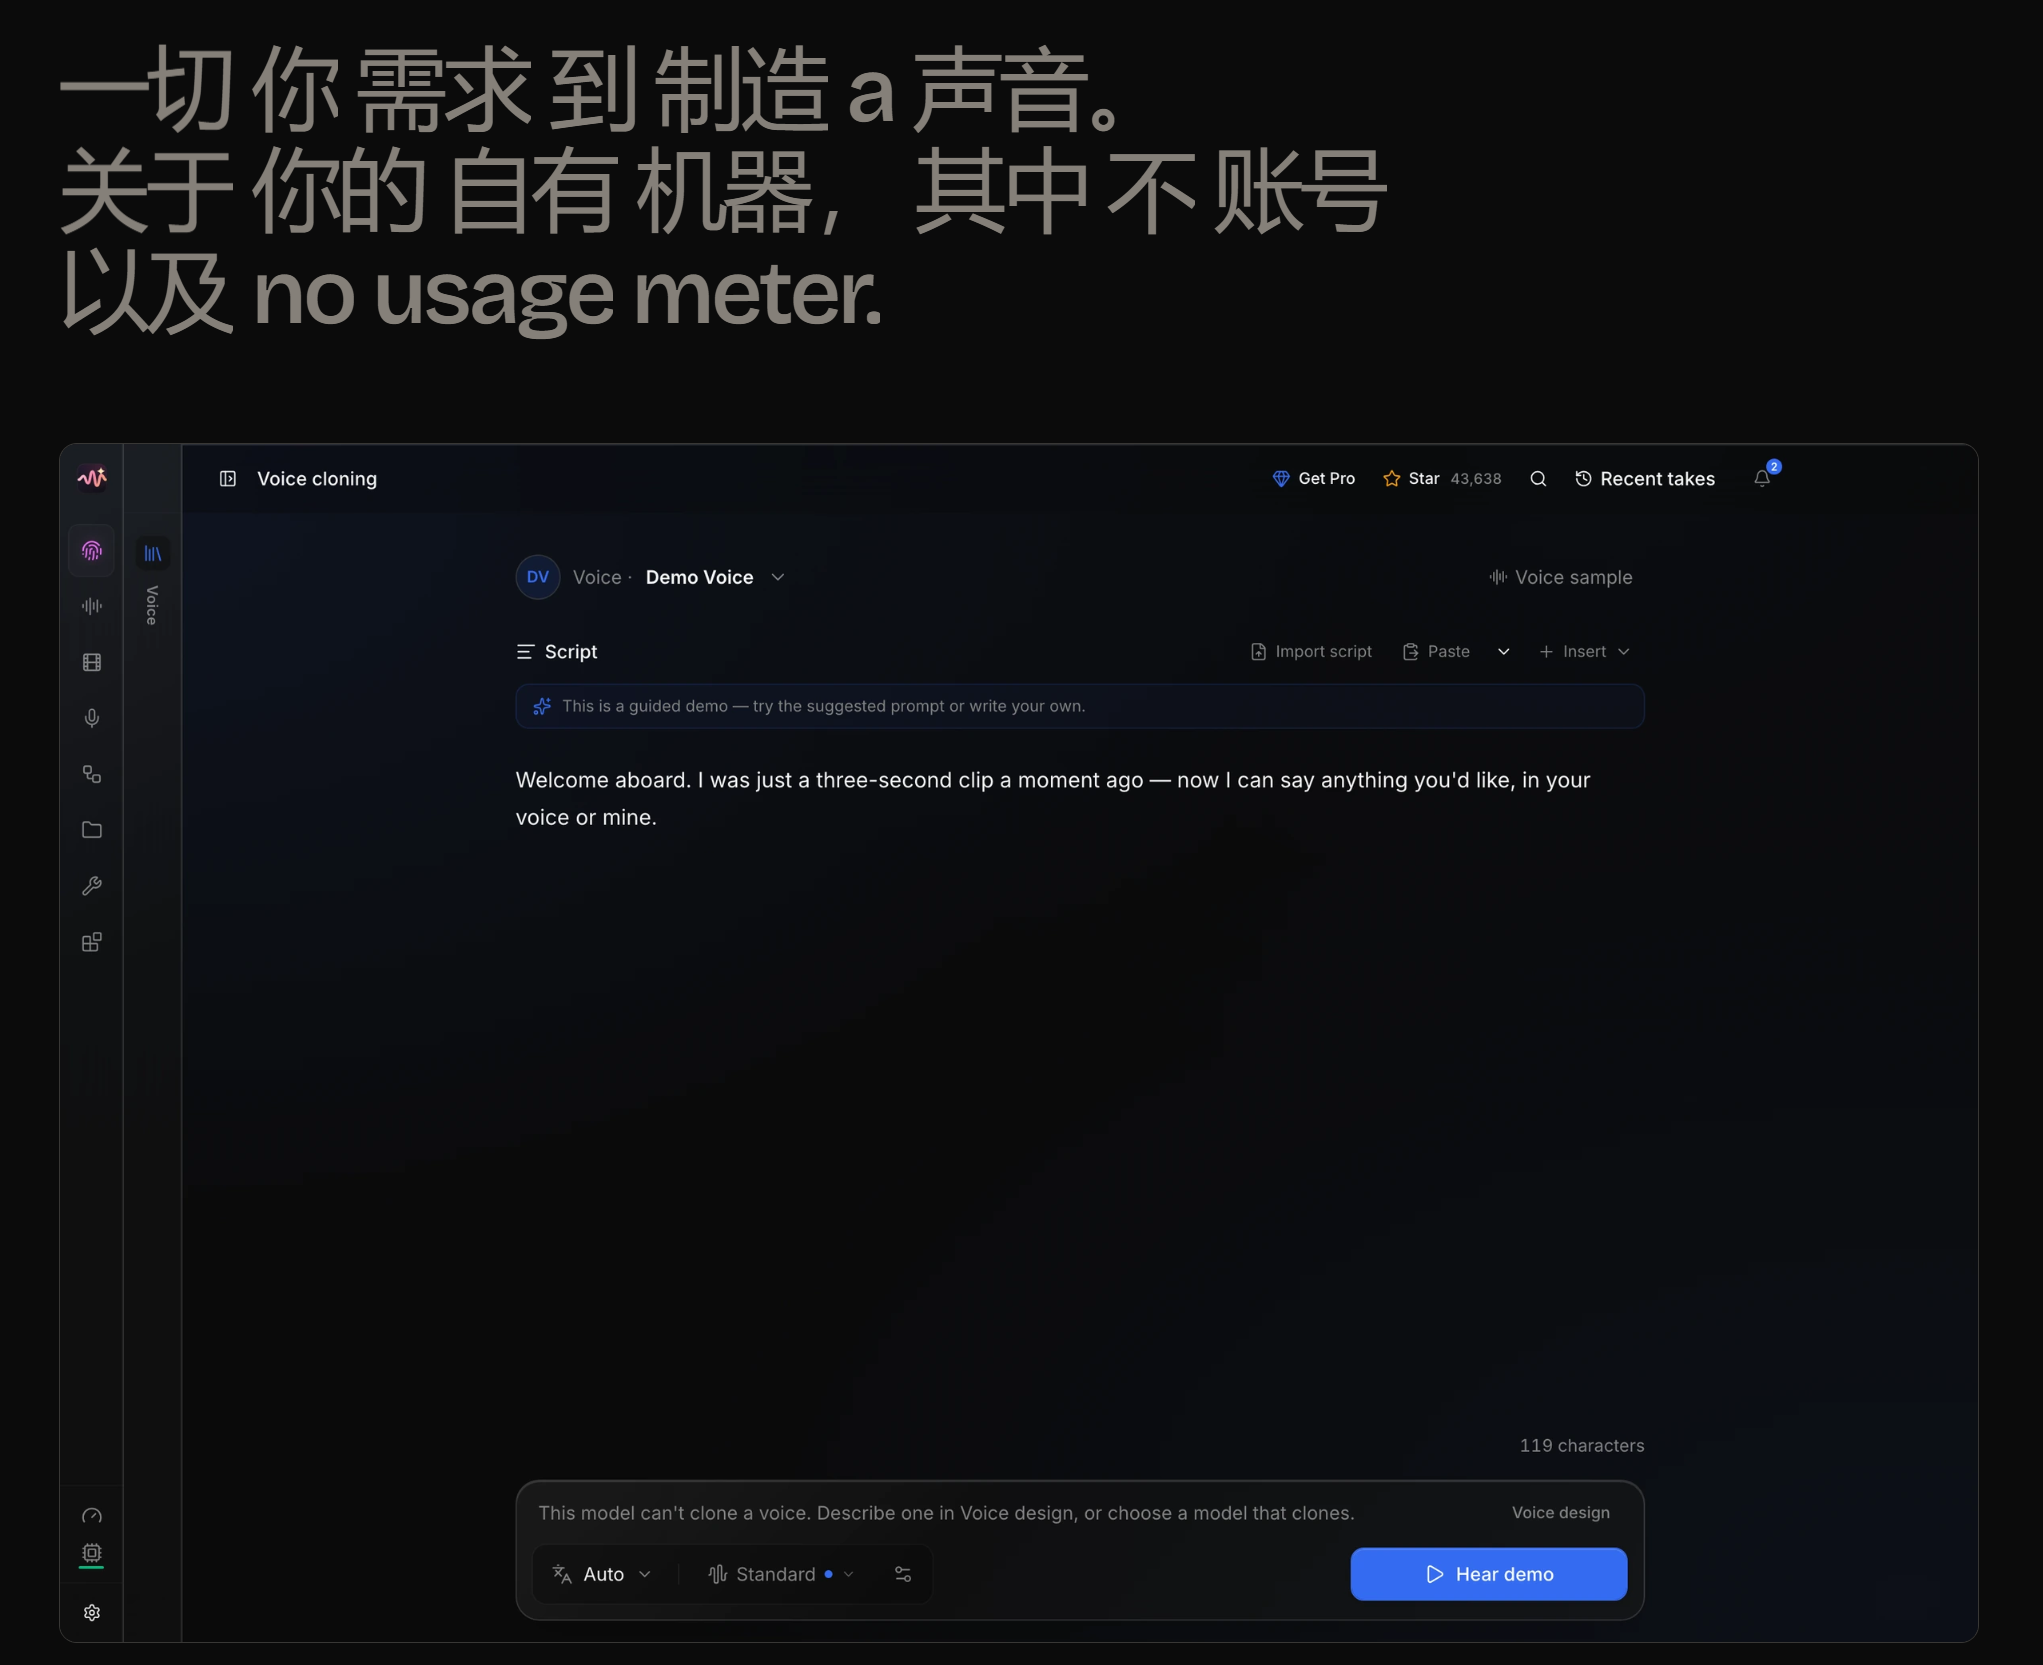
打开声音克隆工作区,可以直接选用内置演示声音,也可以上传一段清晰的参考录音作为音色样本。输入文字后点生成,模型会照参考音色把整段话读出来,长文稿一次合成。首次使用按提示下载对应模型,之后本机运行,素材不外传。需要留意:克隆他人声音前必须取得本人同意,商用还要先确认模型许可条款。
声音设计:用文字造一个新声音
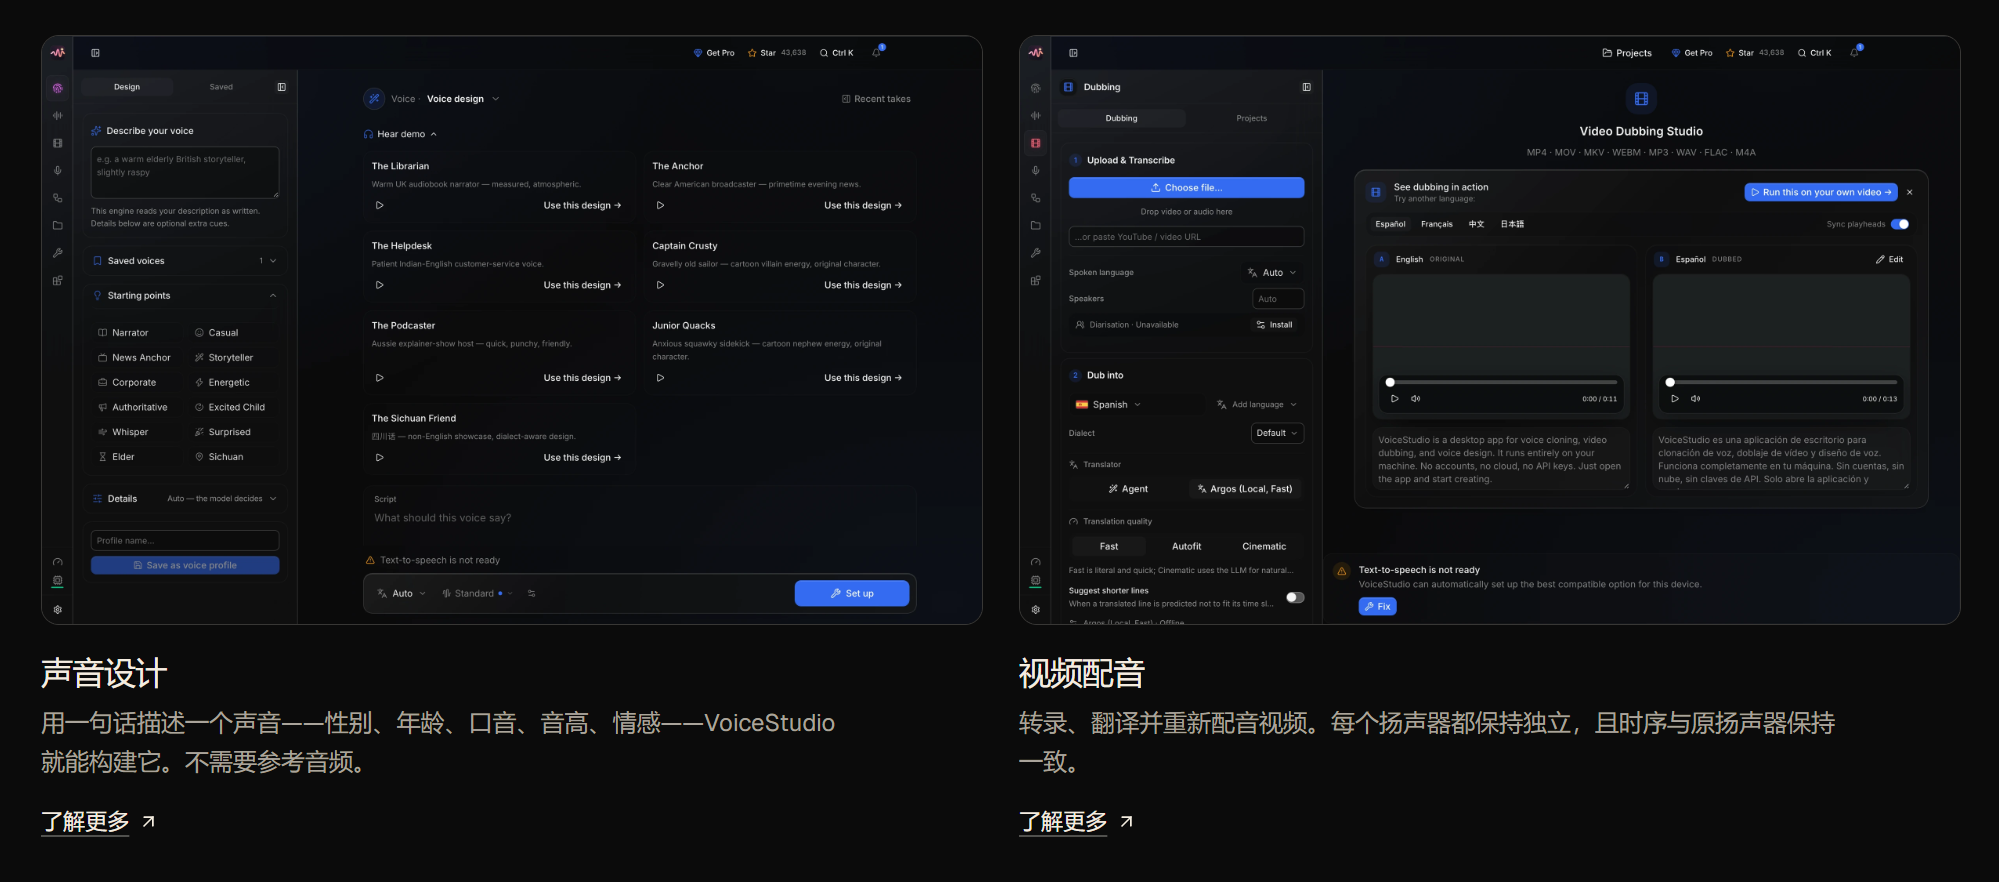
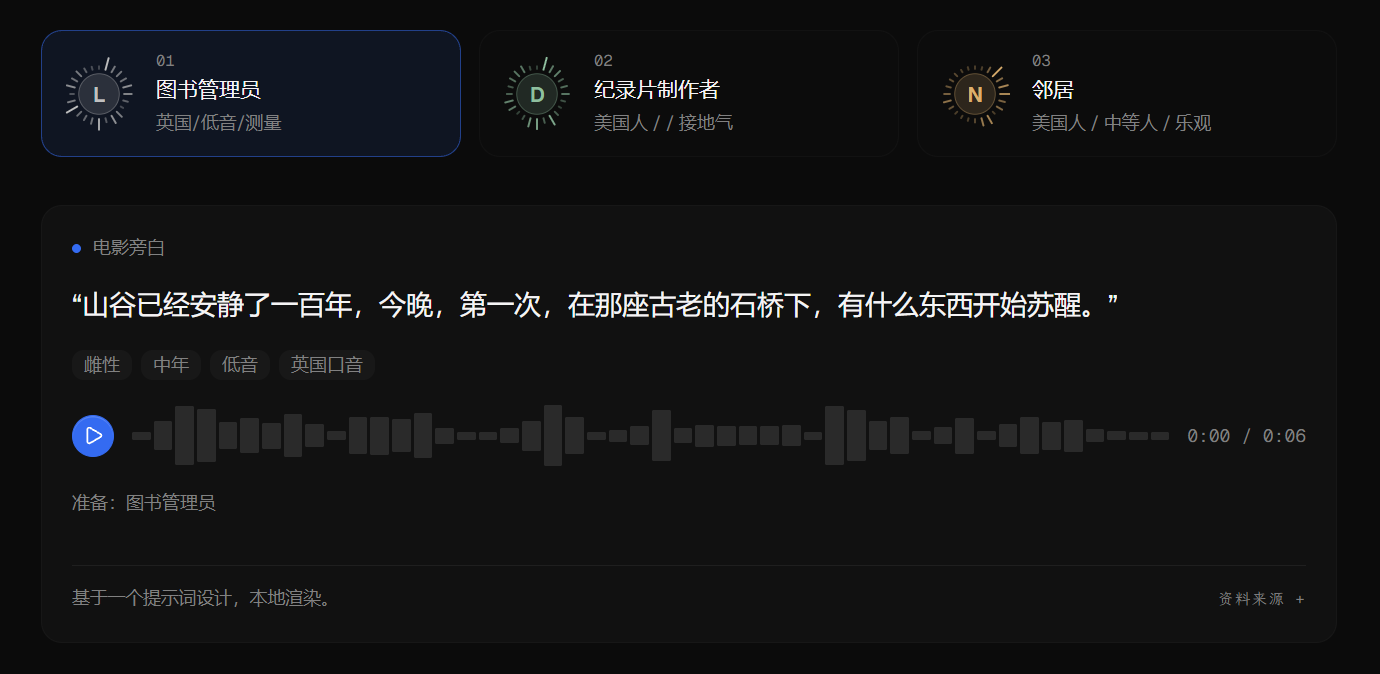
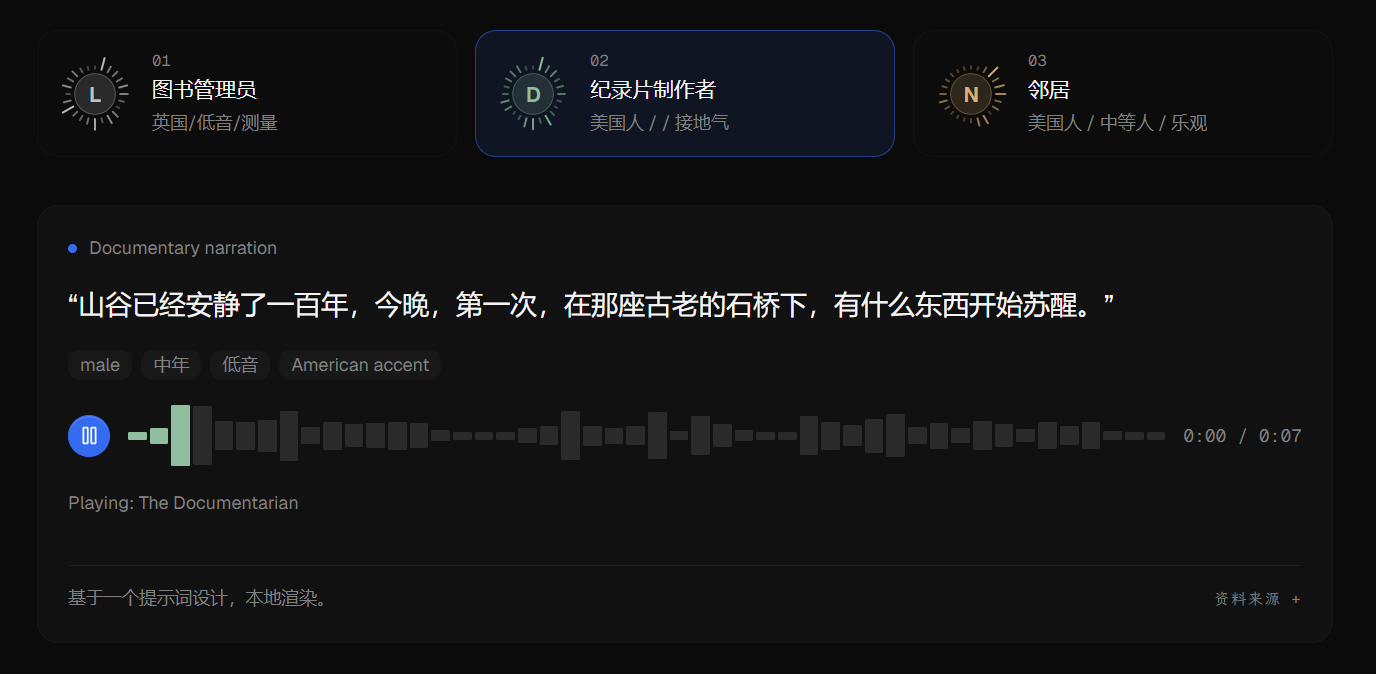
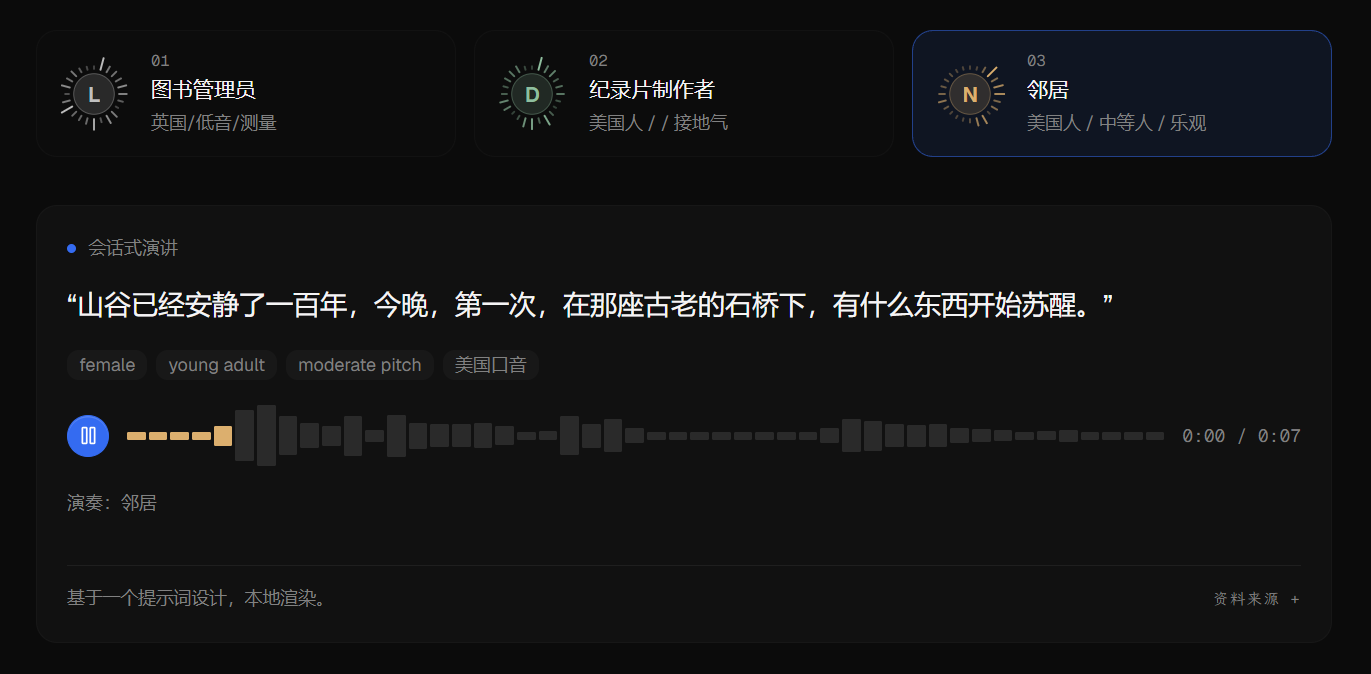
声音设计工作区不需要参考录音,直接写一段描述:想要的年龄感、性别、语速、语调和情绪方向,应用据此合成一个原本不存在的嗓音。它适合角色配音、有声书旁白这类需要虚构角色声线的场景,不用为了找个听感对的人单独录十分钟样音。新声音和克隆声音一起存进声音库,后面的配音、有声书和批量任务都能直接调用。
视频配音:把旁白对齐到时间轴
视频配音工作区导入素材视频,画面时间轴与音轨逐条对应,写好旁白文本就能生成配音,落点跟着时间轴走。需要换语种时,给同一画面重配一条别的语言音轨即可,不用重拍画面。做双语内容时,它把视频处理里磨人的那一段单独拎出来:翻译文本、合成语音、对齐时间轴,以前要在剪辑软件和录音安排之间来回倒,现在一个工作区走完。
悬浮听写与录音转录
听写以悬浮组件的形式常驻屏幕一角,开会、采访、口述笔记时点一下,就把正在说的话转成文字,不用先录好再导进另一个转写工具。长录音转录同样走本地模型,整段音频进去、文稿出来,准确度随所选引擎变化,成稿建议自己过一遍再发。它把语音输入从手机输入法延伸到桌面长文场景,打字慢的人靠它省下逐句敲字的时间。
故事与有声书:文稿进去,整章音频出来
写成一段故事或一本书的文稿,选好旁白声音,应用按章节拆分批量合成,自动处理段落间的停顿与衔接,输出可以直接分发的音频文件。连载内容、课程旁白这类一次产出十几二十条音轨的AI应用场景,任务排队跑完,不用守在电脑前逐条点生成。文字稿先写好,声音由批量任务跟上,人只在导出前试听一遍。
本地模型管理与可替换引擎
所有语音模型在应用内统一下载、安装与更新,装了哪个用哪个,磁盘占用随引擎走。默认引擎是 团队基于 k2-fsa/OmniVoice 做的内置引擎,也支持切换其他引擎。模型与素材默认留在本机目录,这是本地AI路线与云端配音服务最实在的差别:断网也能继续生成,大文件不过别人的服务器。
本地 API、MCP 与智能体接入
应用对外提供本地 API 与 MCP 接口,编码智能体可以直接调用声音生成与听写能力;也可以用一行 npx 命令把VoiceStudio装成智能体技能,接进 Claude Code、Codex、Cursor 这类工具。这套接口让它并进开发者工具链里:批量任务用脚本调度,结果回写到自己的工作流。本机算力不够时可选远程 worker 分担,不开就是纯本地运行。

项目地址
官网 访问
GitHub 访问
下载地址
https://pan.quark.cn/s/6fa1090351ea
相关推荐