想让开源模型替自己写一首歌,最难受的部分是等:一首歌要盯好几分钟,一张显卡一次只伺候一个人,多来几个人就得再买一张卡。给大家推荐一下 YuE2-Turbo ——模型权重一个字不改,只把跑法重做一遍,同一张卡上单曲快 1.68 倍,四个人同时提交时能多跑 3.31 倍的歌。它属于 AI工具 里偏工程的那一类:不追求新效果,只把同一件事做得更快,让同一张卡能多接几个人。
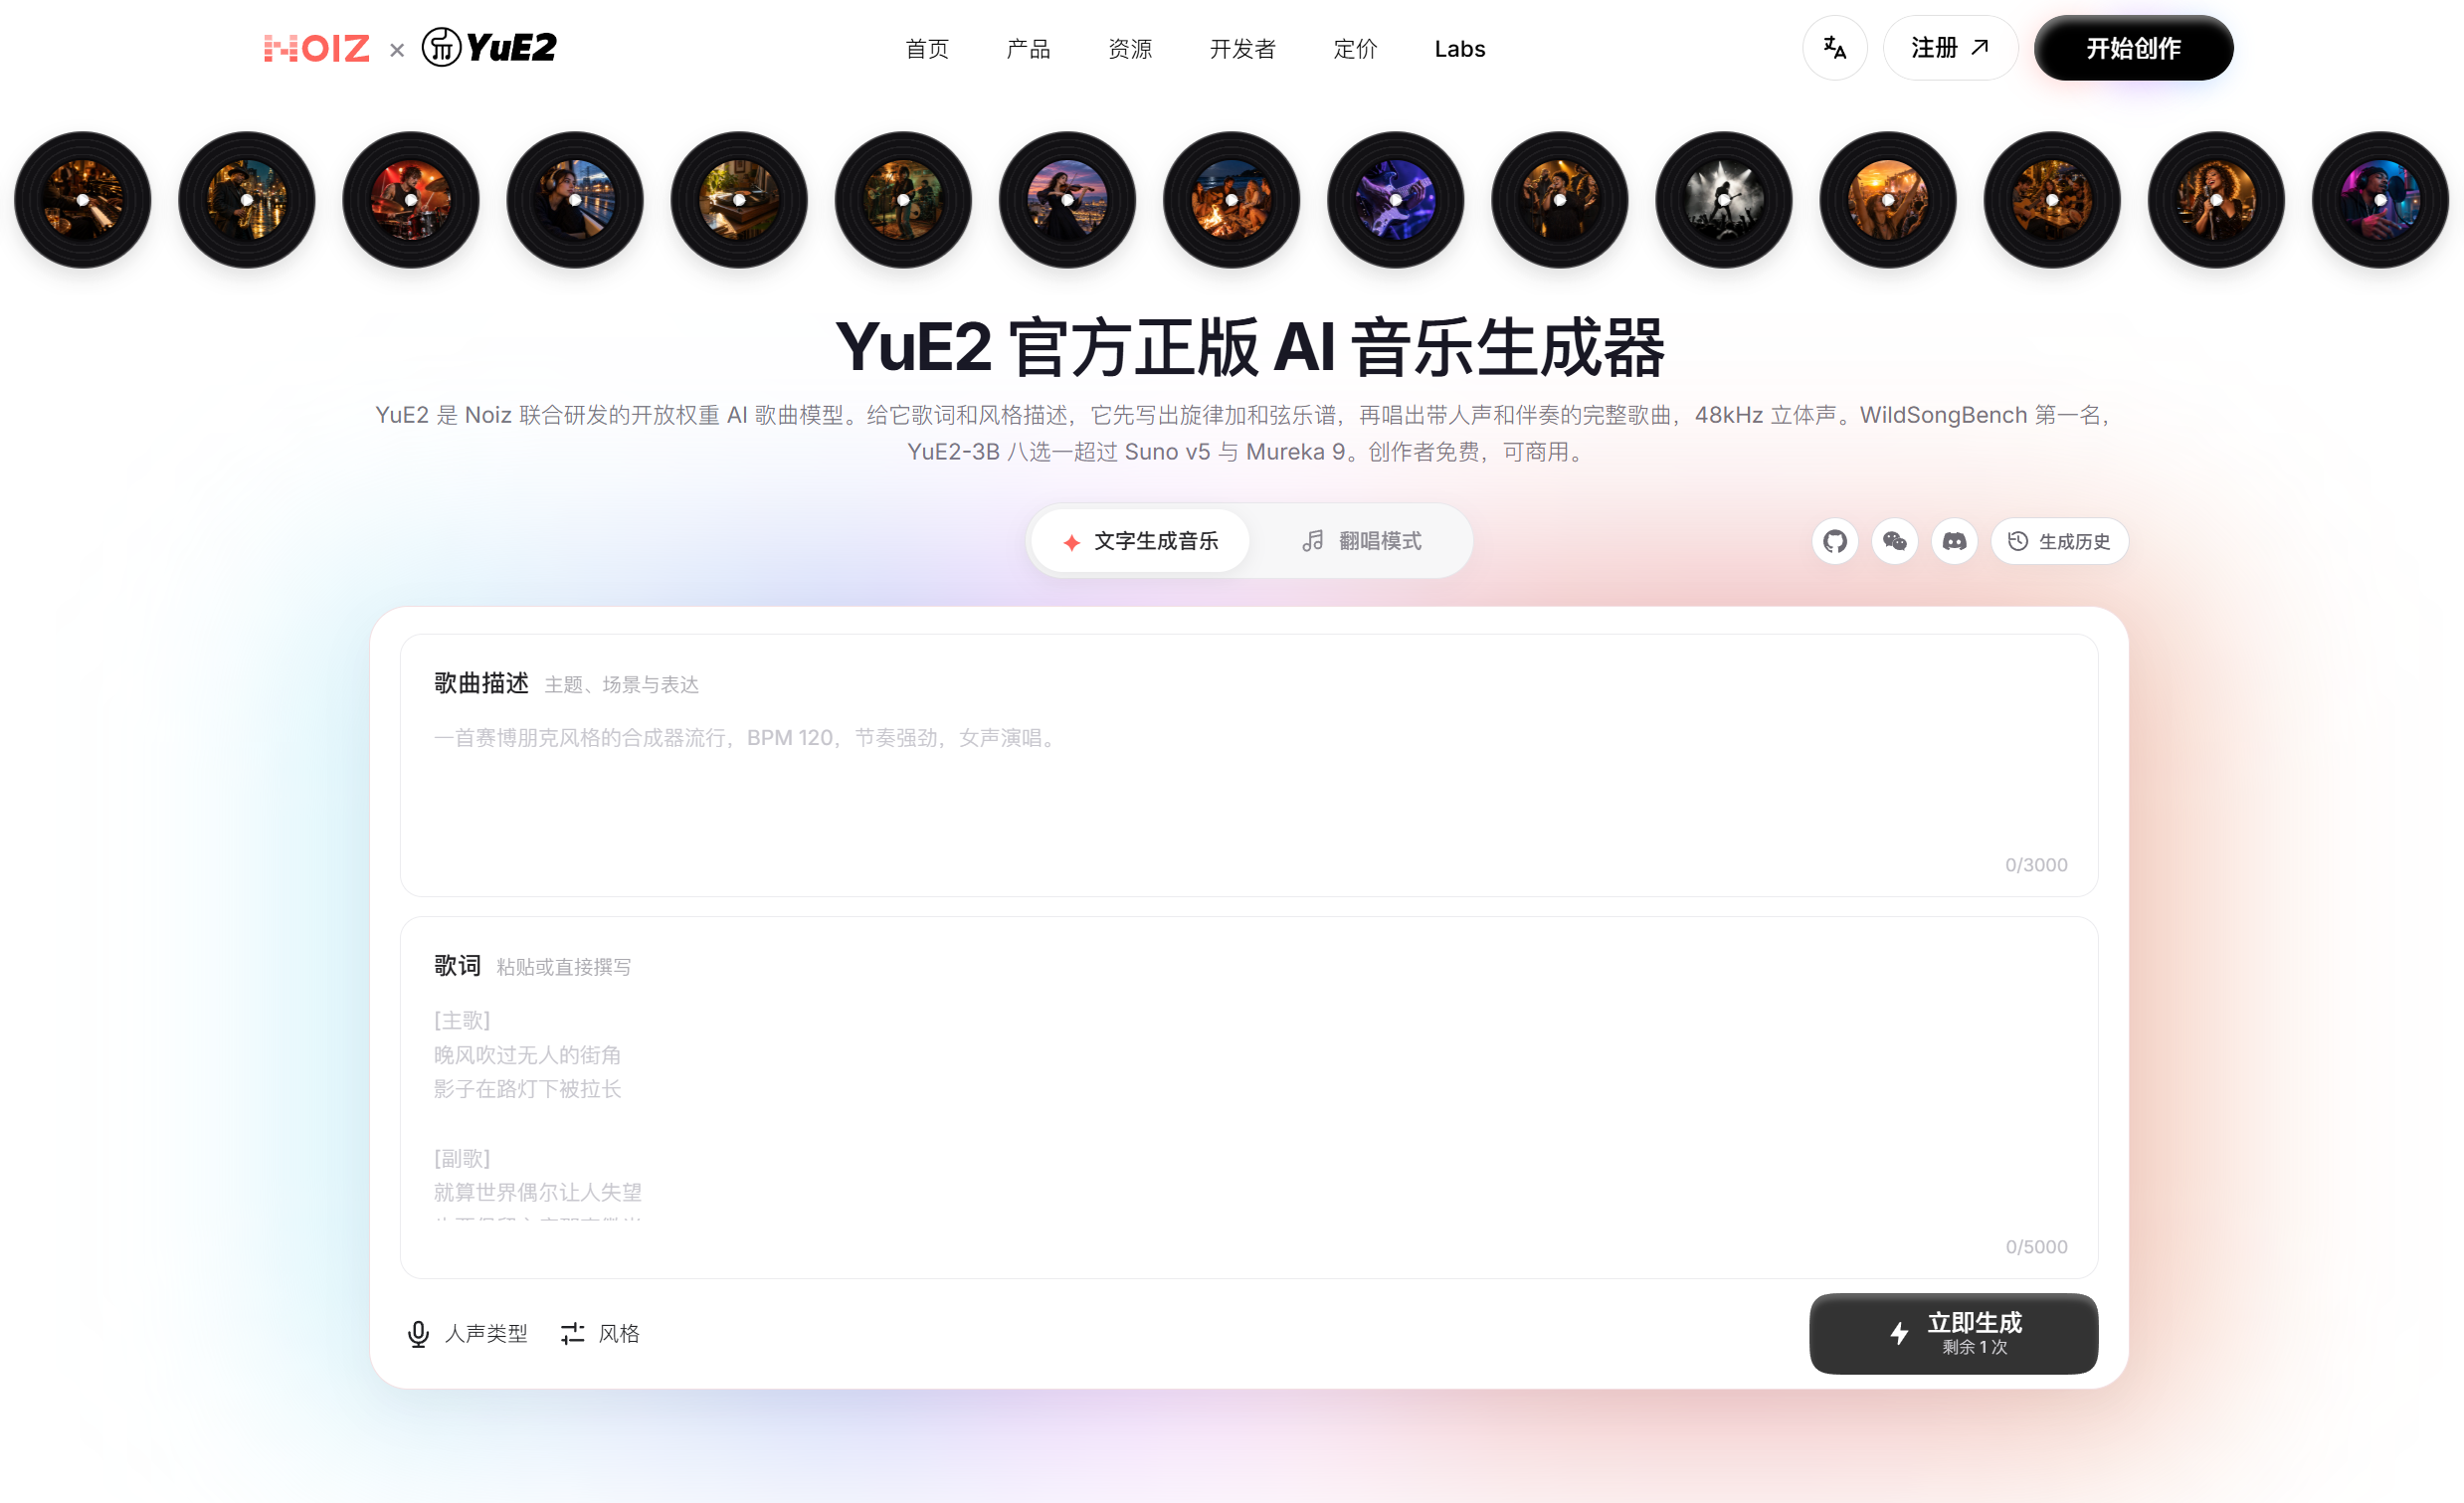
YuE2-Turbo 不是新模型,是一套跑法。它基于社区发布的开源音乐模型 YuE2,沿用官方放出的权重,也沿用原来定好的生成规格。改动全在底层怎么执行上:先把音乐骨架一段段写出来的那一步,交给擅长并行的推理引擎调度;模型权重一直留在显存里,不再每个任务都装卸一遍;最后把骨架变成声音的那一步,允许把几个人的请求凑成一批一起算。
对外给的是一套异步任务接口,做的是 音频处理 这一段的活。另外还有个能在浏览器里用的网页工作台:提交任务拿到编号,过一会儿来取,音频和乐谱都能下载,中途想取消也行。作为 实用软件,它装好就能跑;代码是 开源 的,模型权重却另有非商业用途的限制,这条后面说。
功能特点
快多少:两个数字
两组对比都在同一张 32 GB 显存的显卡上测得,而且是充分预热之后。一个人提交时,生成一秒音频要算的时间从 0.290 秒压到 0.173 秒,快 1.68 倍,一分钟的歌大约十秒算完;四个人同时提交时,整体从 0.317 压到 0.096,快 3.31 倍。
后者看的是排队时的整体效率:几个人排着,显卡一共花多少时间、换来多少秒的歌,0.096 差不多是一分钟的歌六秒。仓库里带了评测命令,可以自己连跑几轮复核。
快在哪:三处改动
- 前一半交给更会排队的推理引擎。
- 权重常驻显存,任务之间不再装卸。
- 后一半允许跨请求凑批;上一批在合成声音时,下一批的前一半已经提前开始算了。
默认配置下这些加速全开着,不用使用者动手改。服务空闲时显存占用约 18 GB,四路并发时峰值控制在 25 GB 以内。同一张卡现在能多跑三倍多的歌,不用为了多接几个人再去买卡,也不用干等。
音质没掉
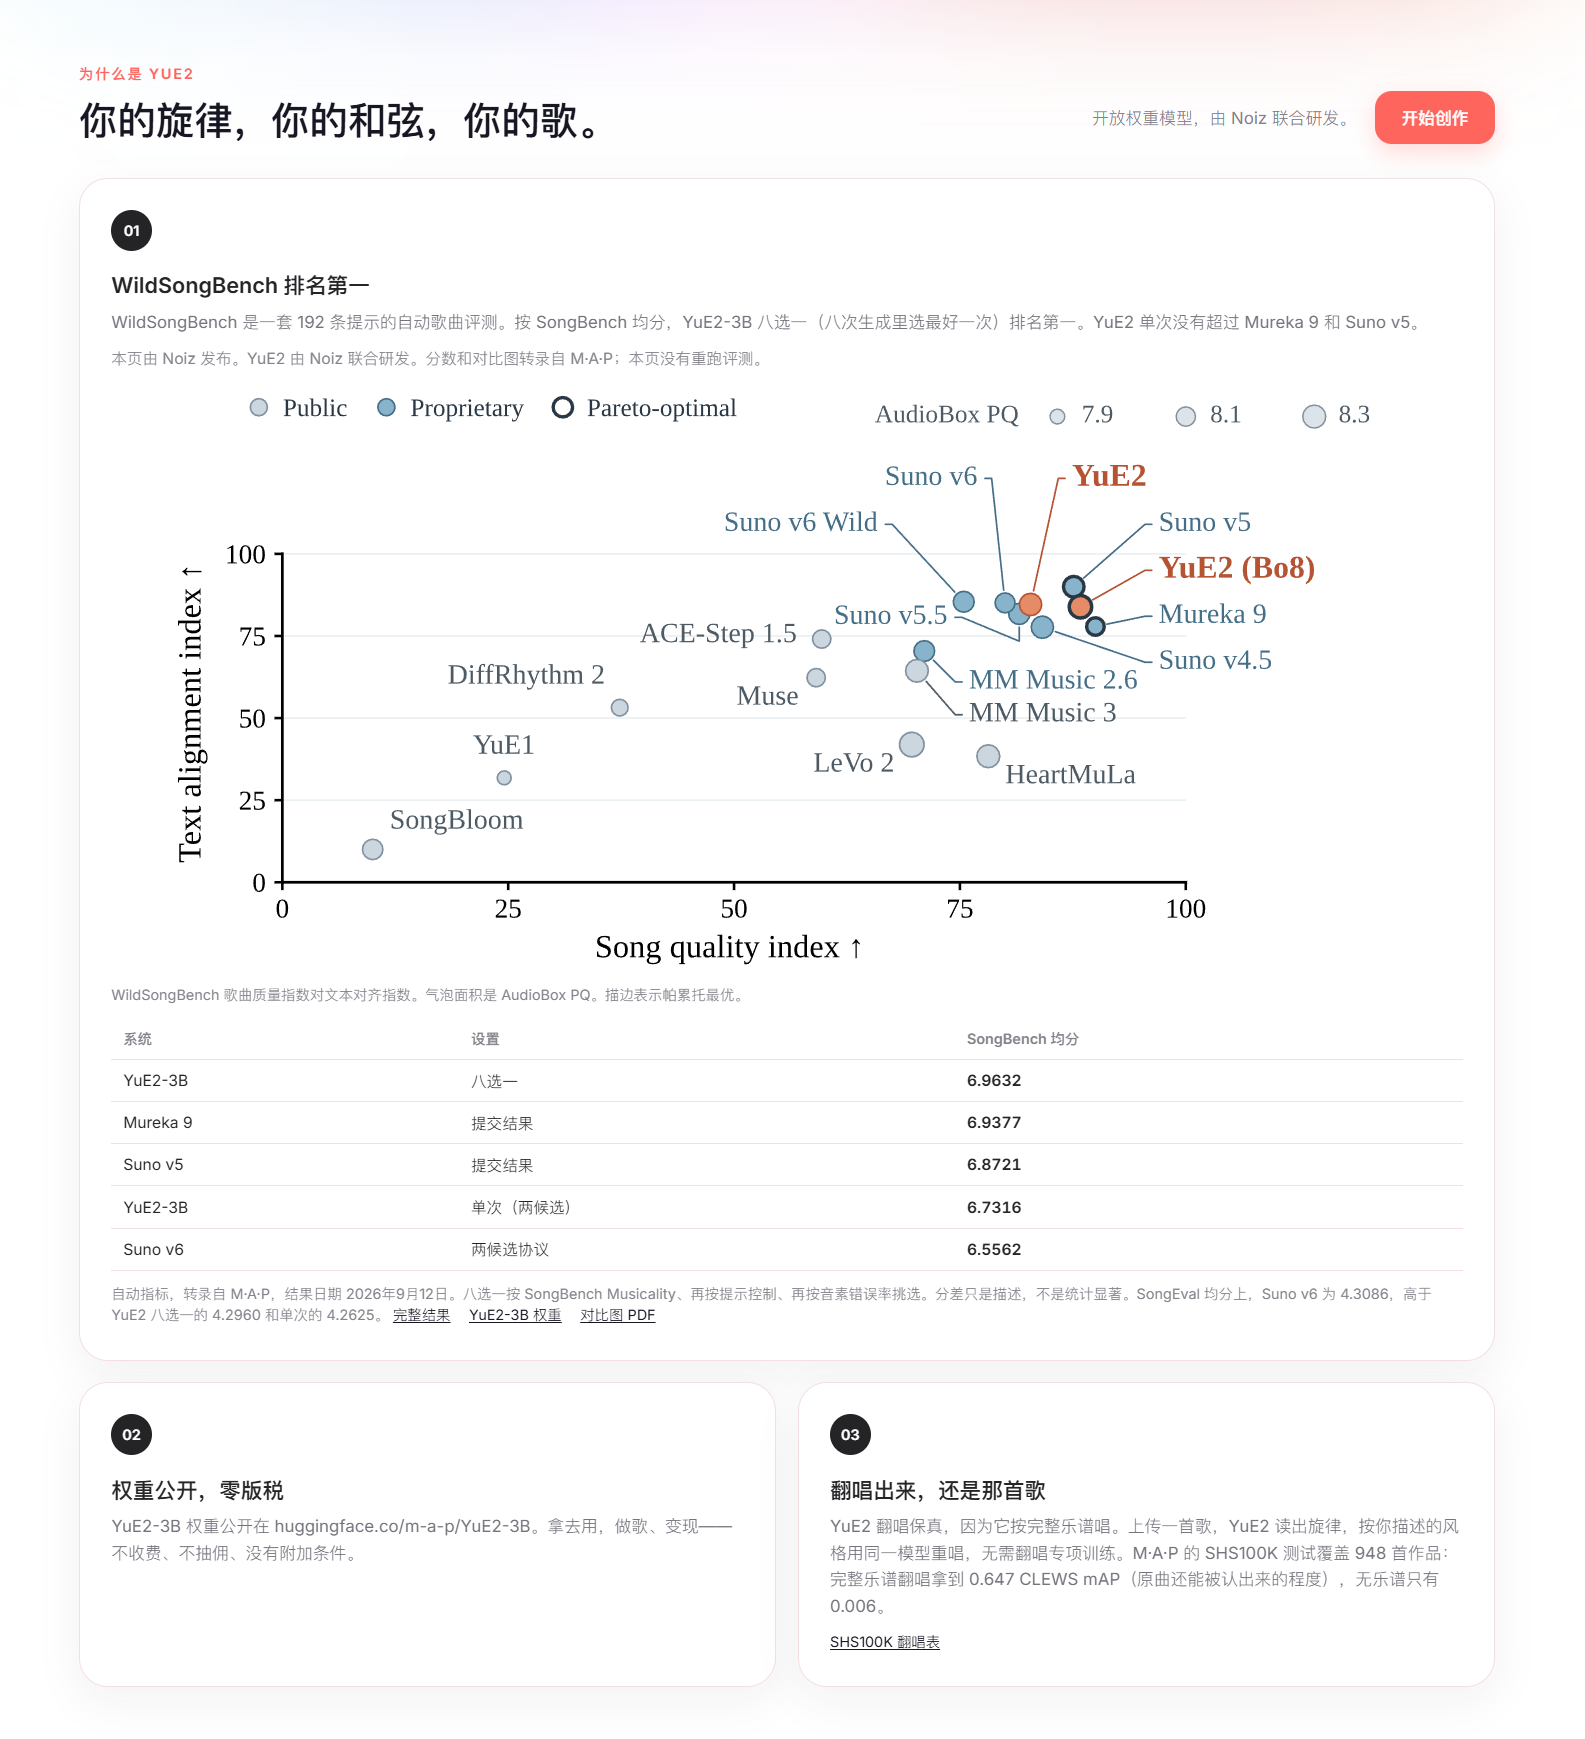
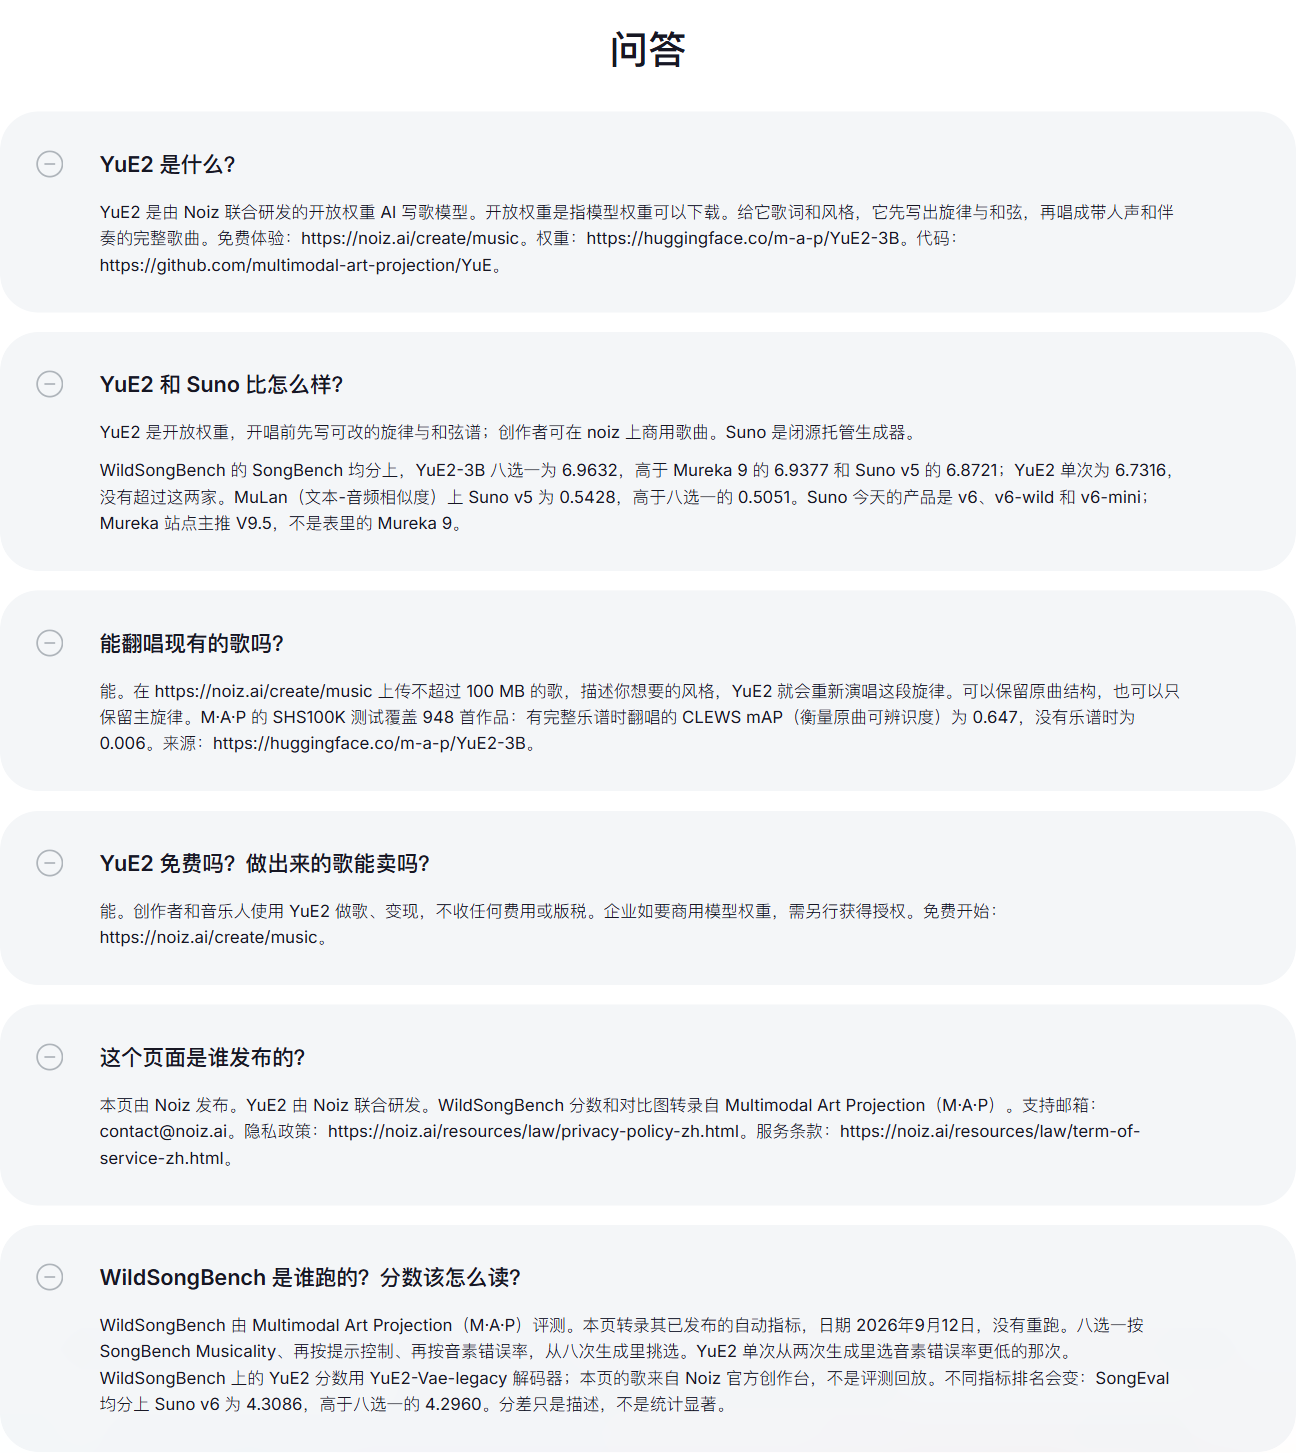
加速最容易让人怀疑的,是拿音质换时间。这是 AI相关 项目里最常见的担心,它用一套公开的音乐评测标准做了对照:一百九十二道题,每题生成两首,取两首里更差的那首来比。综合分从 6.7316 到 6.7623,人声相关的错误率从 8.44% 降到 8.18%,略微变好。快出来的时间不是靠少算几步换的。
接口与网页工作台
任务接口是异步的:提交后返回编号,之后查状态、取消、下载音频和乐谱各走各的地址。状态从排队、在跑,到成功、被截断、失败或被取消,中途能看见停在哪一步、各步花了多久。同样的请求带同一个幂等键,重复提交就返回原来那个任务。产物默认保留 24 小时,或者占满 5 GiB 就清理。
有一处自动让步值得说:请求里用到了原版才支持的采样强度,或者关掉了思维链,服务不硬撑,自己退回原来的执行路径跑完,不用人工干预。
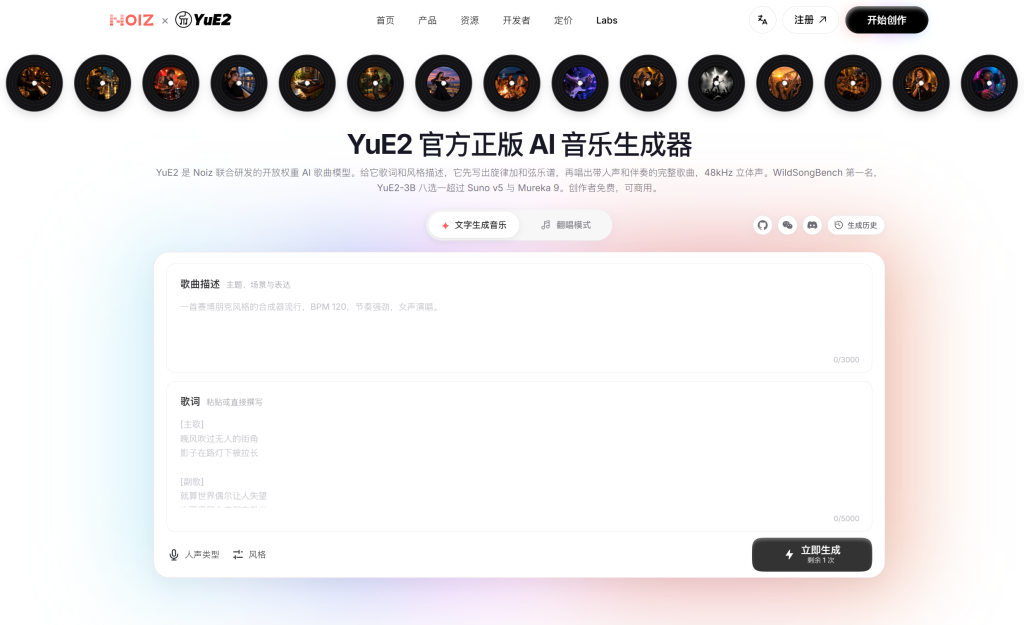
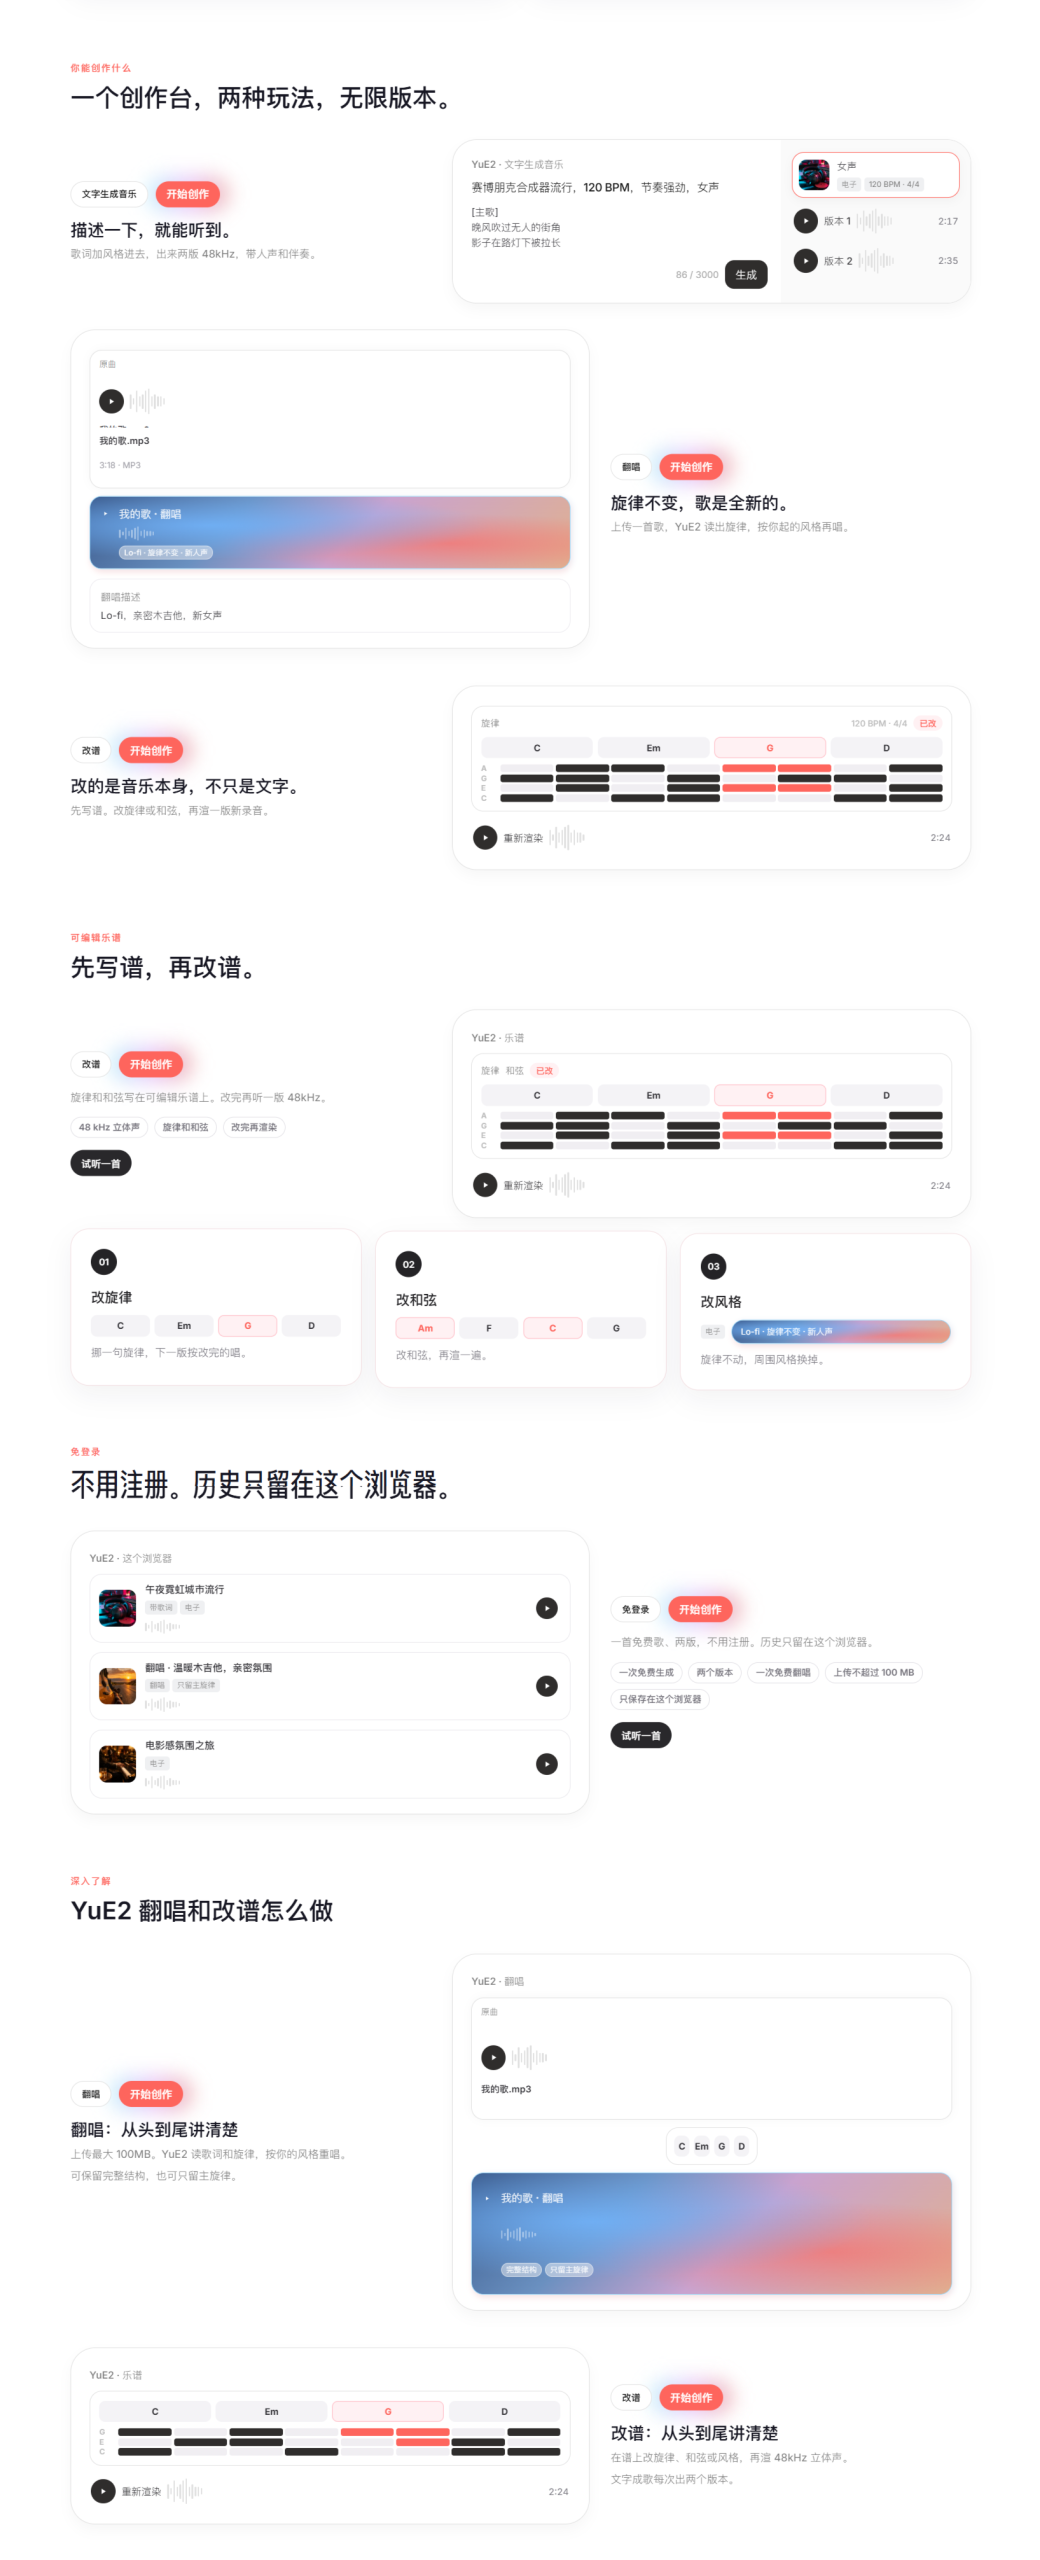
网页工作台 Studio 是一个单页创作界面:填歌词与风格、切换作曲模式、预览乐谱、上传原曲翻唱、看实时进度、试听与下载,都在这一个页面上。密钥由使用者在浏览器里填,网关本身不保存。做 AI应用 的人最在意能不能扛住几个人同时来,这套接口就是为这个设计的。
翻唱
翻唱默认开着:上传一首歌,另一个模型先把它转成不含和弦的旋律谱,YuE2 再照着给定的风格和歌词重新生成一遍,不克隆原唱的音色。转谱那套只在第一次翻唱时载入,平时不占显存;显存够就放显卡上算,不够就交给处理器,24 GB 的卡通常走后者,一首要几分钟,这段时间也算在任务超时里。系统里还得有 ffmpeg。
使用教程
- 先看硬件:要 Linux 系统、一张支持 BF16 运算的 N 卡、驱动支持 CUDA 12.8,Python 用 3.11 或 3.12。默认参数照 32 GB 显卡调;24 GB 的卡把并发数调小,或者关掉权重常驻。模型加解码器约 8 GB 磁盘。
- 安装:从 GitHub 上克隆仓库,建虚拟环境,先装与驱动配套的深度学习框架包,再装服务依赖,里面带了网页框架、服务容器与推理引擎。第一次启动会自动下载权重,想离线跑就把模型目录指到本地。
- 配置三项:接口密钥不少于 16 位、产物与任务库的存放目录、要用的显卡编号(写序号,别写设备编号)。
- 起服务:执行
yue2-serve,默认监听本机 8000 端口。启动时会依次载入推理引擎、音乐模型与解码器,还自动跑一遍预热,之后才是正常速度。加载期间就绪检查返回 503,好了才返回 200;接口文档在本机地址的/docs页。 - 网页工作台:另起一个进程,把上游指到 8000,默认开在 8016。
- 多张卡就一张卡起一个进程,分别设好显卡编号、端口和数据目录,前面用反向代理分流。别让多个进程共用一个数据目录,服务会给目录加进程锁。
使用感受
最实在的一点是它没动模型。很多人对「加速版」的担心是偷偷少算几步、拿音质换时间。这里把对照分数直接摆出来,连两首里更差的那首都比过了,综合分和人声错误率都略微变好。
另一处是它不硬撑。用到原版才有的采样强度、或者关掉思维链的请求,服务自己退回原来的路径跑完,不用人工判断;翻唱也一样,显存不够就退到处理器上,代价是一首多等几分钟,写在文档里。
在 工具推荐 里,肯把对照分数一起贴出来的项目不多。它也不是谁都能用:要 Linux 加一张不小的 N 卡,模型权重还是非商业许可,想拿它赚钱得先看条款。想要一个能把开源音乐模型跑得更快的 开发者工具,它值得一试。
官方网站
GitHub:访问
下载地址
https://pan.quark.cn/s/4ff708057baa
https://www.guangyapan.com/s/1951479615364771901_aeWhI5wocgzRgCO6(光鸭新用户注册福利:永久免费空间:所有新用户注册即可解锁 2TB 永久免费存储空间,无需额外任务或付费)
相关推荐

SmartSub 妙幕 – 视频自动生成字幕、翻译和字幕合并工具|一站式 AI 视频转字幕、翻译、配音
 2026-07-24