给视频配旁白的人,大多绕不开同一个循环:稿子改一版,声音就得重录一遍。找人录要排期,用在线服务按字数掏钱,稿子还得先传到对方机器上。今天给大家推荐一下 这个名为 yovoice 的应用:把模型下到自己电脑里,录一段自己的声音,让稿子照这个声音念出来。
yovoice 是给 macOS 和 Windows 做的声音创作工具,装在电脑上把文字念成语音,顺带管着音色和成品。放在 本地AI 这一挂里,它属于把整条流程都留在机器上的那种:不调云端接口,不按字数计费,参考音频和模型也不出本机。
安装形态上,macOS 要 14 以上、Apple 芯片的机器,Windows 要 10 或 11 的 64 位版本。模型在应用内下载,卸载后用户目录下的作品与模型会保留。它是 开源软件,代码公开在仓库里。
场景痛点
做 播客 或者口播视频的人,最耗神的往往不是写稿,而是改稿之后那一步。 一段两百字的旁白,改到第八版就得录第八遍,语气还得跟前面几段对上。找人代录要排期、要返工;用在线服务,长稿念下来开销不小,未公开的内容还要先传到别人服务器上,这步很多人过不去。
自己动手也不轻松:装环境、下模型、敲命令,对不写代码的人是道坎。就算跑通了,换语气、换音色往往又是一轮折腾。归到 音频处理 这一类看,缺的不是能出声的工具,而是出声之后还能反复改、又不把内容交出去的。
功能特点
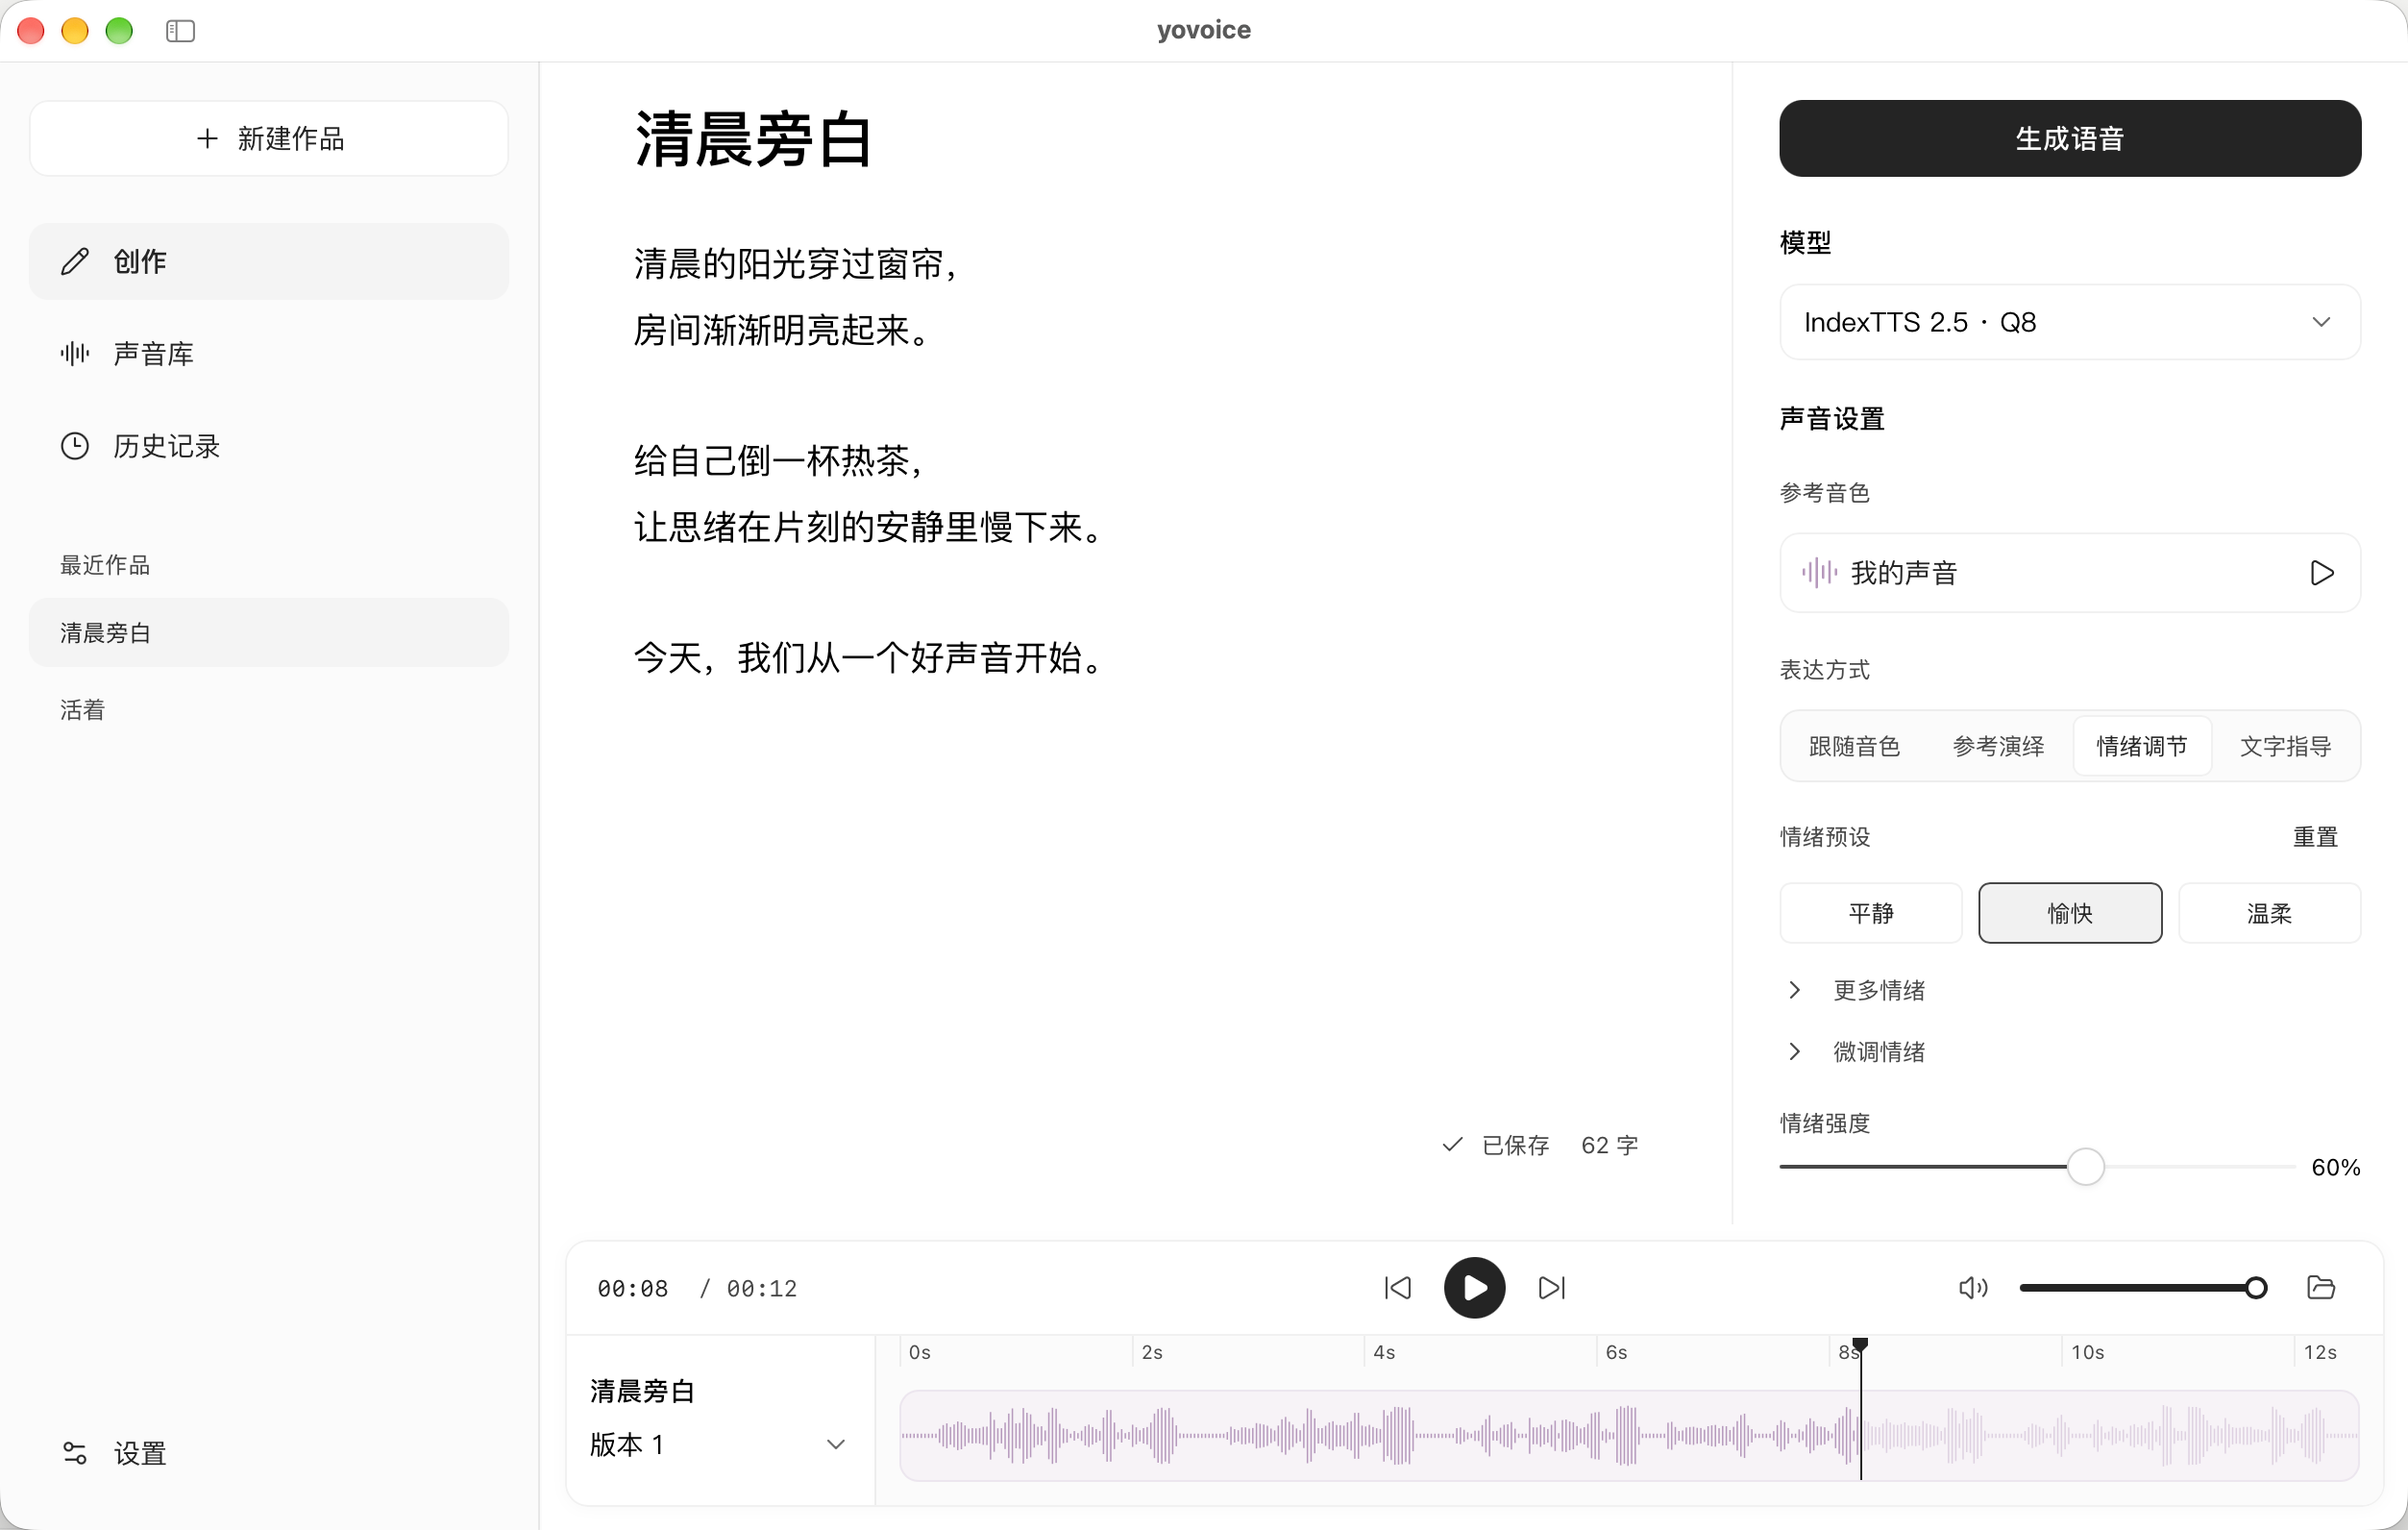
- 音色与表达 — 跟随参考音色、模仿参考演绎、调整情绪,或用文字描述想要的表达方式。
- 完整音频流程 — 导入或录制参考音频、裁剪片段、试听语音、导出作品。
- 声音设计与克隆 — VoxCPM2 支持文字设计音色、带风格指导的克隆及参考原文辅助的精细克隆,自动多语言、48 kHz 输出。
- 本地模型 — 通过 audio.cpp 运行 IndexTTS 2.0 / 2.5、VoxCPM2、OmniVoice 和 Qwen3-TTS,支持模型下载续传与 GGUF 导入。
- 硬件加速 — Apple Silicon 支持 Metal;Windows 支持 CPU、NVIDIA CUDA 和实验性 Vulkan。
- Agent Skill — 让 AI Agent 准备本地语音生成环境,根据文稿和参考音频完成配音。
一、三种来路的音色
第一条路是克隆:导入或录一段 1 到 60 秒的音频,之后的稿子照这个声音念。第二条路是设计:不给参考音频,用一句话描述想要的声音,年轻女声、低沉男声都行,三个模型支持这种玩法。第三条路是直接用现成的,其中一个模型自带九种内置音色,用文字就能改风格。
想更贴近就得给原文:提供录音时把这段音频实际说的话一并交给它。OmniVoice 把这一步设成硬性要求,不给原文就走不通。
二、情绪、发音与非语言声音
情绪这层有四种入口:直接说想要什么情绪、照着一段参考演绎来、自己填一组数值,或交给它随机挑。可填的情绪有八个维度,高兴、愤怒、悲伤、害怕、厌恶、低落、惊讶、平静,强度能调。念错的字也能改:其中一个模型支持在正文里给字标注发音,选中即可调。
正文里还能插标签,写一句「你好」再跟一个笑声标记,生成出来就是带着笑声的一句,这类标签有十几种。
三、长稿子与成品管理
长稿不一次念完,而是切成几段分别生成,段与段之间可留停顿。切多长、怎么切都能调,也可交给模型自己定。生成不是边念边出声,而是整段做完才播放。其中一个模型遇异常会自动重试,最多三次。对要反复改稿的人,这属于 效率工具 的思路:改完一段,重生成这段就行。
成品、音色和设置都放在用户目录下的固定文件夹里,卸载也还在;以往作品能在历史记录里翻出来,参数一并留着。
四、硬件与模型下载
苹果芯片走 Metal;Windows 自带 CPU 内核,装好就能用,想用英伟达显卡要在设置里另下内核,另有一套实验性方案。模型在应用内下载,下到一半断网可以接着下;已有模型文件也能直接导入登记。作为 AI工具,把选择权留在本地是它最不一样的地方。
五、不开界面也能配音
除了桌面应用,官方还有独立的命令行版本,支持苹果芯片的 macOS、64 位 Windows 和 Linux,也不用另外准备网页运行库。装好配套技能后,可以直接对智能体说一句:用这段录音的音色念这份稿子,语气平静,存成文件。剩下的交给它在后台跑完。
| 模型 | 核心能力 |
|---|---|
| IndexTTS 2.0 | 中英音色克隆、情绪控制、参考演绎 |
| IndexTTS 2.5 | 多语言音色克隆、情绪控制、发音调整 |
| VoxCPM2 | 文字设计音色、音色克隆、参考原文辅助的精细克隆 |
| OmniVoice | 属性设计音色、音色克隆、非语言声音标签 |
| Qwen3-TTS Base · 0.6B / 1.7B | 参考音色克隆、可选原文辅助、多语言生成 |
| Qwen3-TTS CustomVoice · 1.7B | 9 种内置音色、文字控制风格与情绪 |
| Qwen3-TTS VoiceDesign · 1.7B | 自然语言描述设计音色,无需参考音频 |
使用教程
第一步,装应用。在发布页选对应平台的安装包:macOS 是磁盘映像,打开后把图标拖进应用程序文件夹;Windows 是安装向导,装完从开始菜单打开。缺少网页运行库时安装器会联网补装。归到 实用软件 里,它属于装完还要再走一步的。
第二步,下模型。第一次用先到设置里挑一个模型下载,体积 1.35 GB 到 8.08 GB,机器一般就先试小的。Windows 版已内置 CPU 内核,要用英伟达显卡再下内核。
第三步,加音色。录一段或导入一段 1 到 60 秒的音频,起个名字;不想录音就用文字描述,或直接用内置音色。参考音频支持常见的七八种音频格式,最长 60 秒,最大 20 MB。
第四步,生成与导出。把稿子贴进去,选情绪或语气,点生成,听完满意再导出;成品是 wav 文件,历史记录里能找回。归到 AI相关 这一类,整套流程不联网也能走完。
使用感受
第一点,音色这层的门槛是分层的:不想录音就描述,有录音就克隆,想更贴近再补原文。
第二点,本地不是口号。模型、参考音频、成品都在本机,不调云端接口,也不按字数收费;代价写在明面上——模型动辄几个 GB,机器得撑得住。
第三点,边界交代得清楚。有一个模型权重只能用于非商业用途,另有一个模型自带单独协议;所有模型都整段生成完才出声,不是边生成边听;同一数据目录不能被桌面应用和命令行同时占用,关掉窗口不算退出,要走退出菜单。
第四点,影音编辑 这个分类放在它身上稍宽,但方向没错:配音从找人、买服务变成机器上的一道工序,改稿重录终于不用再看排期。
官方网站
https://github.com/leemysw/yovoice
下载地址
https://pan.quark.cn/s/f5536e027a1f
https://www.guangyapan.com/s/1949291452793872437_aeWhI5wocgzRgCO6
相关推荐
video-subtitle-generator 视频字幕生成器:Windows 本地 Whisper 批量转录与双语字幕工具
 2026-09-10

SmartSub 妙幕 – 视频自动生成字幕、翻译和字幕合并工具|一站式 AI 视频转字幕、翻译、配音
2026-07-24