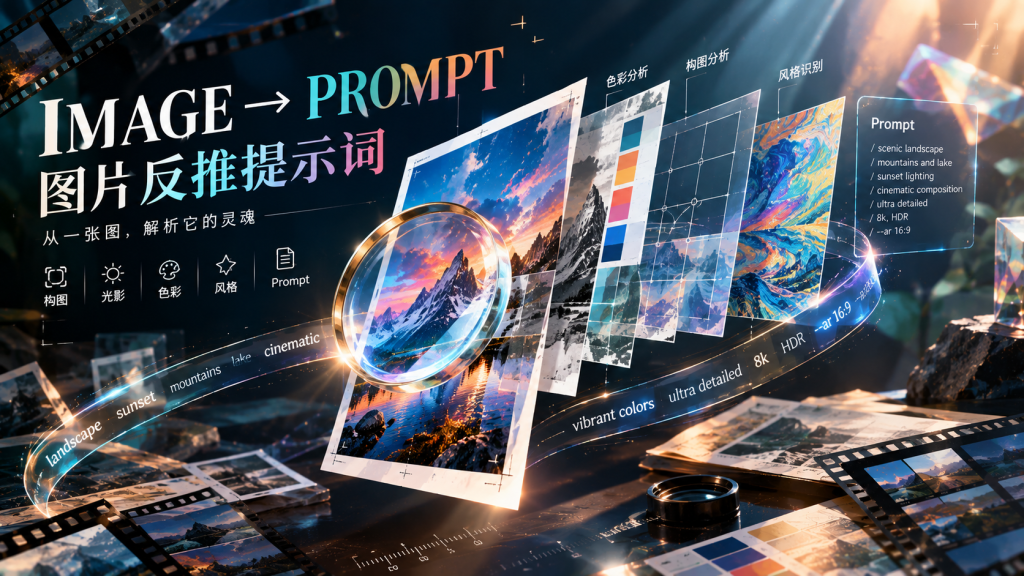
看到一张喜欢的图,问作者用了什么提示词,多半问不出来。反推提示词这事一直有人做,路子却没怎么变:把图描述一遍,再补几个风格词。不如试试 image-prompt-reverse 按画面证据倒推最可能的原始提示词,中英各给一套。
它是什么
image-prompt-reverse 是一个 开源 的 AI 技能包,装进智能体的技能目录就能用。给它一张图,它交回一份「能再造出这张图」的提示词:简体中文一套、英文一套,外加风格标签和一份按字段分好的结果。作者把它定位成一次取证:从画面里能看到的东西往回推,不替这张图重新构思。归到 AI相关 这一类很合适,整个项目不依赖任何第三方包。
场景痛点
常做图的人都有这个感受:刷到一张对味的图,最想知道的不是它好不好看,是怎么做出来的。去问作者,多半不回;找工具反推,出来的又是一段看图说话——「一个女人站在街头」,这种描述谁都写得出来,拿去出图却完全不是那回事。真正难的是把光线、构图、镜头感、材质这些细节一层层挖出来。GitHub 上这类 AI工具 不少,能直接拿去复刻的不多。
功能特点
| 产出 | 说明 |
| 🇨🇳 中文重建提示词 | 简体中文自然段落,约 200 到 300 字 |
| 🇬🇧 英文重建提示词 | 英文自然段落,约 90 到 150 词,与中文对齐 |
| 🏷️ 风格标签 | 中英文各 4 条,短词为主,方便当小胶囊展示 |
| 🧩 分字段结果 | 12 个字段,主体、姿态、光线、构图、材质等分门别类 |
| 🔁 复刻提示词 | 信息量最大的一条,单行 130 到 220 词,可直接投喂出图模型 |
| ⚡ 精简版 | 把主体、构图、光线、风格、配色压成一两行 |
| 🚫 负面提示词 | 针对这张图列出会破坏画面的问题,不是通用词堆砌 |
一、给一张图,交回一整包
流程就三步:先把图真正读进来,再按契约产出一份按字段分好的结果,最后跑一遍校验。图可以是本地文件,也可以是网址(先存到本机再读);长边超过 2200 像素时会先压一道。作者强调必须真看到图像内容再分析,不凭文件名猜。
二、只写看得见的东西
三条铁律贯穿全程。第一,只复原不创作:每一条描述都得在图里找到对应,品牌、画师姓名、镜头型号、渲染器名称、画面上的具体文字,一律不许编。证据不足就写宽一点,比如「深色硬质台面」而不是硬编一种木材。第二,不许用「高清」「杰作」这类空话顶替具体描述,要写就写「左上方硬光在鼻侧留下锐利阴影」。第三,画面里只要有人,就必须给出族裔外观线索和肤色,实在判断不了就明写「族裔外观无法判断」,肤色与发型照写。
三、中英分桶,还要查两遍
双语输出最典型的翻车是中文桶里夹大段英文、英文桶写成中文。它的做法是分桶硬判:中文桶要求汉字不少于 8 个、假名不超过汉字数的百分之八;英文桶要求字母不少于 24 个且至少是汉字与假名总数的两倍。更细的一层是单字段检查,提示词这一项要单独再判一遍。原因很实在:整段合并着算会被长的那半边稀释,实测出现过提示词写错语言、解说写对却判通过的情况。中文侧的口径也收紧成汉字数不少于字母数。
四、不合格时怎么修
校验脚本零依赖,退出码 0 通过、1 是语言或标签不合格、2 是结构缺字段。不通过时按固定顺序自愈:结构坏了先用结构修复指令补齐字段,语言串味就用语言修复指令重写那一桶——只搬运和翻译,不许新增任何画面细节。两轮之后仍不合格就明确报错,不会把串味的结果交出去。标签太长也有处理:英文标签按一张缩写表归一(比如把冗长的摄影说法压成两个词),再去重、最多留 4 条。
五、什么时候该用它
该用的场合很明确:反推或解析某张图的提示词;想知道一张 AI 图、海报或杂志页是怎么生成的;想照着风格写一段能反复用的提示词。不该用的也写清楚了:只要一句图片描述,直接看图回答就行;真要出图,那是生图工具的活;修图、去水印另找别家。对常做 内容创作 的人来说,这条边界很有用。
使用教程
第一步,装技能。把整个目录放进智能体的技能目录,例如 WorkBuddy 的 ~/.workbuddy/skills/,不需要装任何依赖包,只要 Python 3.8 或以上。
第二步,把图给进去。本地文件直接读;网址先存到本机再读,防盗链取不到就自己存一张。图太大先压一道。
第三步,说一句话。对智能体说「反推提示词」「这张图用了什么提示词」「照这张图的风格帮我写」都可以,剩下的按契约走,产出一份按字段分好的结果文件。
第四步,跑校验并交付。执行目录里的校验脚本,退出码 0 才算过;需要整理标签时再加一个参数。通过后在回复里直接给出中英文两套提示词和 4 条风格标签。作为 实用软件,它把「不确定就别交付」这件事做成了硬规矩,这也配得上 AI应用 里偏实用的那一类。
使用感受
它跟「看图说话」是两回事。普通反推给你一段描述,它给你的是一份证据链:主体、姿态、空间层次、光线方向、构图、镜头语言、色彩与画幅,八类观察项一类不落。差别就在细节上——描述说「街头有个女人」,它会说光从哪来、阴影多硬、机位多高。
三条规定全是「不许」:不许编造看不见的东西,不许用空话凑数,不许语言串味。校验器也只判桶对不对,不判写得好不好——质量下限交给契约里的规则。这种把边界写成硬约束的做法,比多堆几个功能难得。
作为 Skill工具,不是独立软件。整个项目就三样东西:一份技能说明、两份契约与规则文档、一个零依赖的校验脚本。想接进自己的智能体,拷目录就行。归到 AI教程 这一类也说得通——那份契约本身就是一份写提示词的教材。对 大语言模型 的能力边界,它处理得挺老实:看不清就写看不清,不硬编。
官方网站
下载地址
https://pan.quark.cn/s/6353c2ba1cb0
https://www.guangyapan.com/s/1948932795946225717_aeWhI5wocgzRgCO6
相关推荐
Vivid Figures 生动数据图:让 AI 用数据生成科研图表的工具|两种风格、五套配色、内置 108 个图表配方覆盖常见科研图型
 2026-09-15
Lieflat Charts – 面向 AI Agent 的数据可视化 Skill 使用教程|三套视觉风格、49 个图型与12 套报告模板
2026-09-10