
Hacker Books 是一个把 Hacker News 评论里反复出现的书整理出来的推荐聚合站,也算近来少见的一个宝藏网站。它分析了 2007 到 2026 年间 HN 上的公开评论记录,只收录被至少两位不同用户提及过的书,最终沉淀出一万五千多本。书籍元数据来自 Open Library,站点和背后的数据管线几乎全由 Claude 编写。它和 Y Combinator、Hacker News 本身没有隶属关系,只是借用了 HN 的评论数据做源头,最早以 Show HN 的形式挂出来,讨论串里不少人拿它和各类算法书单做对照。
场景痛点
想找书时,算法推荐越推越窄,榜单又常常被营销节奏和流量绑架;真想去 HN 翻评论,又像在十几年的聊天记录里捞针,翻到的人凭运气,翻不到的人只能跟着热搜走。这种宝藏资料型的聚合站做的事,是把谁真的在多年里反复提起某本书这件事量化出来,按数字摆在你面前,让你看到的是长尾共识,而不是一次性热搜。
主要功能特点
十五年评论沉淀的书单
数据源是 open-index/hacker-news 这套 HN 评论数据集,时间跨度从 2007 年一直拉到 2026 年。收录门槛不低:一本书至少要被两个不同用户提起过才会进库,单条刷屏或小号自嗨的进不来。最终库里有一万五千多本书,按提及人数和推荐人数排序,沉淀的是资源发现层面的长期共识,而不是某一周的热度峰值。
每日重洗的今日书架
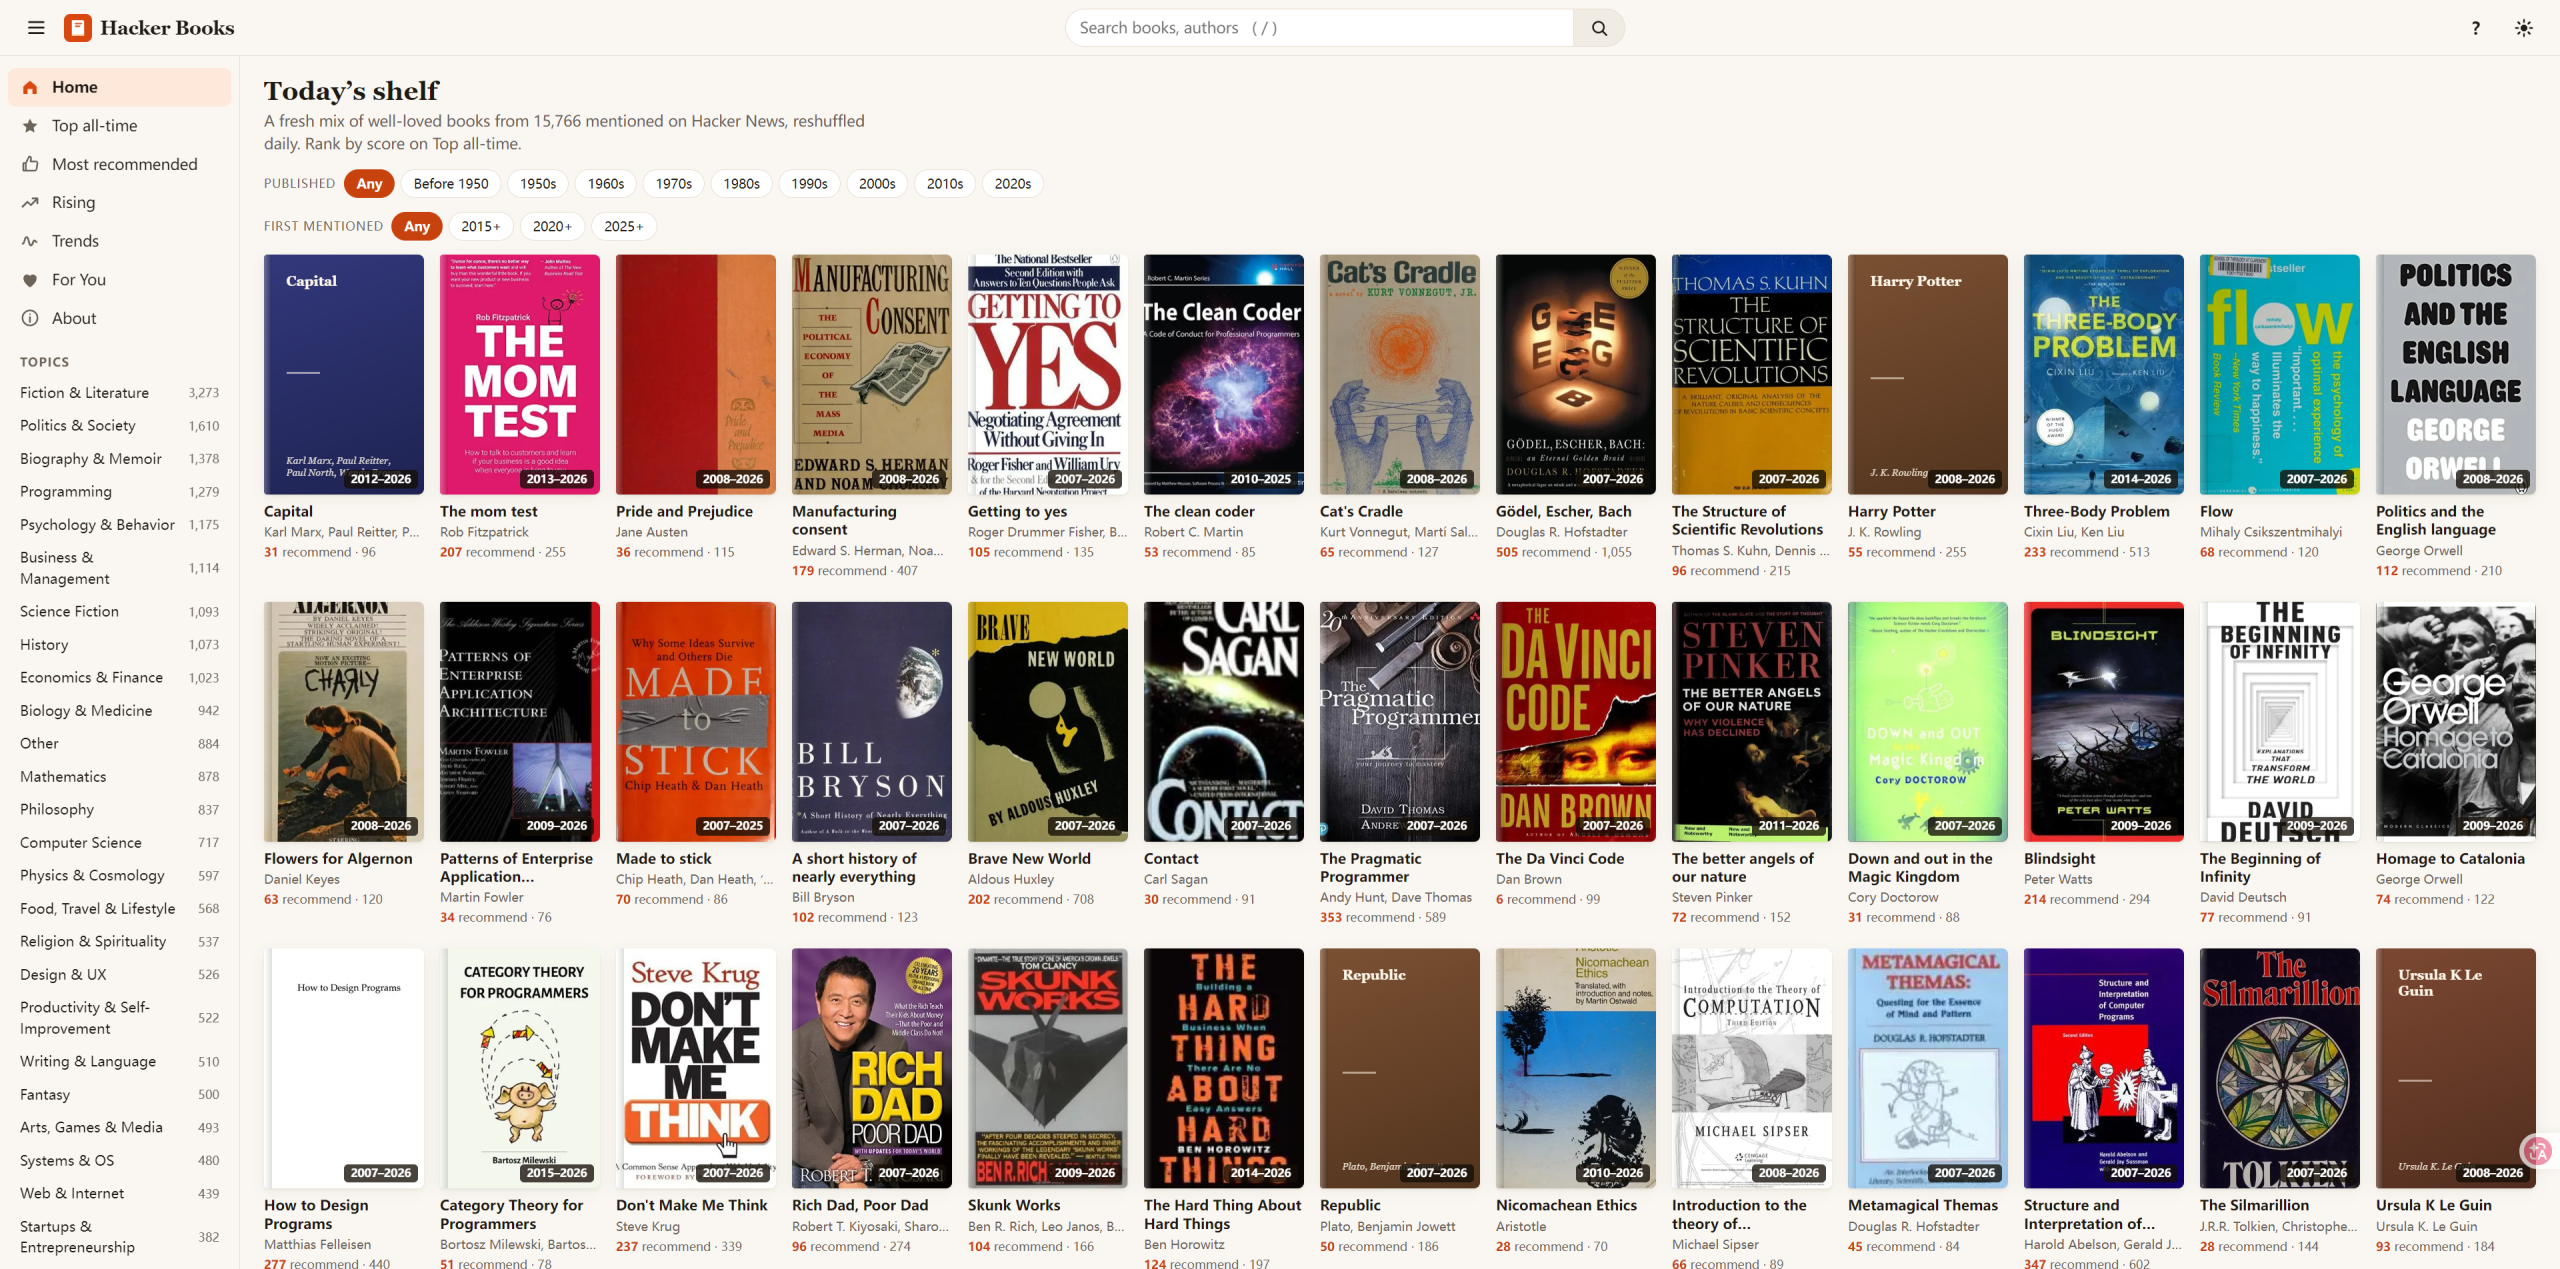
首页叫 Today’s shelf,每天用 Top All-time 总分把整库重新排一遍。意思是你哪天打开,看到的封面墙都是按历史推荐分重新洗出来的结果,没有编辑排期,也没有付费位。对过着数字生活、习惯隔三差五回来逛一眼的人来说,这种每日一换的封面墙比固定榜单更容易发现新书。
数字分层的封面卡
每张封面卡下面直接印书名和作者。红色数字是推荐人数,灰色数字是提及人数,封面右下角标着这本书第一次到最后一次在 HN 被提起的年份,比如 2007-2026。两个数字并排看,能立刻分辨被随口提过和被认真推过的区别,这也是它和普通网站推荐类榜单最不一样的地方。
单本书的评论情感切片
点进详情页,顶部一排指标:提及总次数、推荐人数、参与评论的 HN 用户数、首末被提及年份。下面用 Claude 把每条相关评论归成推荐、中立、批评、与书无关四类,画成百分比条形图。比如 Mistborn 是 182 次提及、94 人推荐,情感分布为 59% 推荐、33% 中立、8% 批评,很适合当学习资源对照看。
Claude 汇总的推荐理由
详情页有一段 Why HN recommends it,是 Claude 从所有推荐类评论里归纳出来的:这个社区到底为什么反复提这本书。旁边附主题标签和内容简介。需要说明的是,情感分类和理由归纳都是大语言模型推断,没有人工逐条审,个别书的元数据也对不齐,比如 Mistborn 的首版年份就被标成了 2001 年,实际是 2006 年。
主题与年代过滤
左侧导航分 Home、Top All-time、Most Recommended、Rising、Trends、For You 几栏。Topics 下分小说文学、政治社会、编程、心理、商业、经济等十几个分类,还能按出版年代和首次被提及年份两层过滤。这种按时间维度切片的资源合集,在酷软趣站里并不多见。
几乎全由 Claude 搭起来的站点
这个站本身和它的数据管线几乎全是用 Claude 写出来的,从评论清洗、书目匹配、情感分类到前端页面,相当于一个大模型全栈产出的可读产品。它不是开源仓库,代码不公开,更适合当成一个现成的读书工具来用,而不是二次开发的起点。对一个有趣网站来说,看点一半在书单本身,另一半在这种模型全栈产出的样子。
项目地址
相关推荐
cs329z-chinese — 斯坦福 AI Agents 中文自学教程,19 讲讲义加 4 个动手练习
 2026-11-03